AI駆動開発入門
【はじめての LSHC×AI駆動開発】0-3:LLM のしくみ
0-1 では、Claude に会議メモをまとめてもらいました。そのとき、Claude は「LLM(大規模言語モデル)」だと紹介しました。この回は、その LLM が中で何をしているのかを見ます。しくみが分かると、Claude がなぜ得意なことと苦手なことを持つのか、どう頼めば間違いが減るのかが、理由ごと分かるようになります。この先の章で Claude に仕事を任せるときの土台になる回です。
1. この回の用語
| 用語 | ひとことで |
|---|---|
| トークン(token) | LLM が文章を扱うときの最小の単位。単語、単語の一部、文字などに当たる。1トークンが何文字かは、言語とモデルによって違う(出典[1]) |
| 事前学習(pretraining) | ラベルの付いていない大量の文章で、それまでの文章から次の単語を予測するように学ばせる、最初の学習(出典[1]) |
| RLHF(Reinforcement Learning from Human Feedback、人間のフィードバックによる強化学習) | 人が2つ以上の答えを比べて順位をつけ、上位の答えに近い出力をするようにモデルを学ばせる方法(出典[1]) |
| コンテキストウィンドウ(context window) | 答えを作るときに、モデルが振り返って参照できる文章の量。学習したデータの量ではなく、モデルの「作業メモリ」に当たる(出典[1]) |
| 非決定性(non-determinism) | 同じ入力でも、毎回同じ出力になるとは限らない性質 |
| ハルシネーション(hallucination) | 事実と違うことや、渡した資料と食い違うことを、LLM がもっともらしく書いてしまうこと(出典[2]) |
2. 場面:同じ頼みなのに、答えが違う
3. LLM は、次のトークンを予測している
LLM が文章を作るときにしていることは、1つだけです。それまでの文章を見て、次に来るトークンを予測することです。
トークンは、LLM が文章を扱うときの最小の単位です。英語なら単語や単語の一部、日本語なら1〜数文字ほどに当たり、1トークンが何文字になるかは言語とモデルによって変わります(出典[1])。料金や、一度に渡せる量の上限は、文字数ではなくトークンの数で決まります。
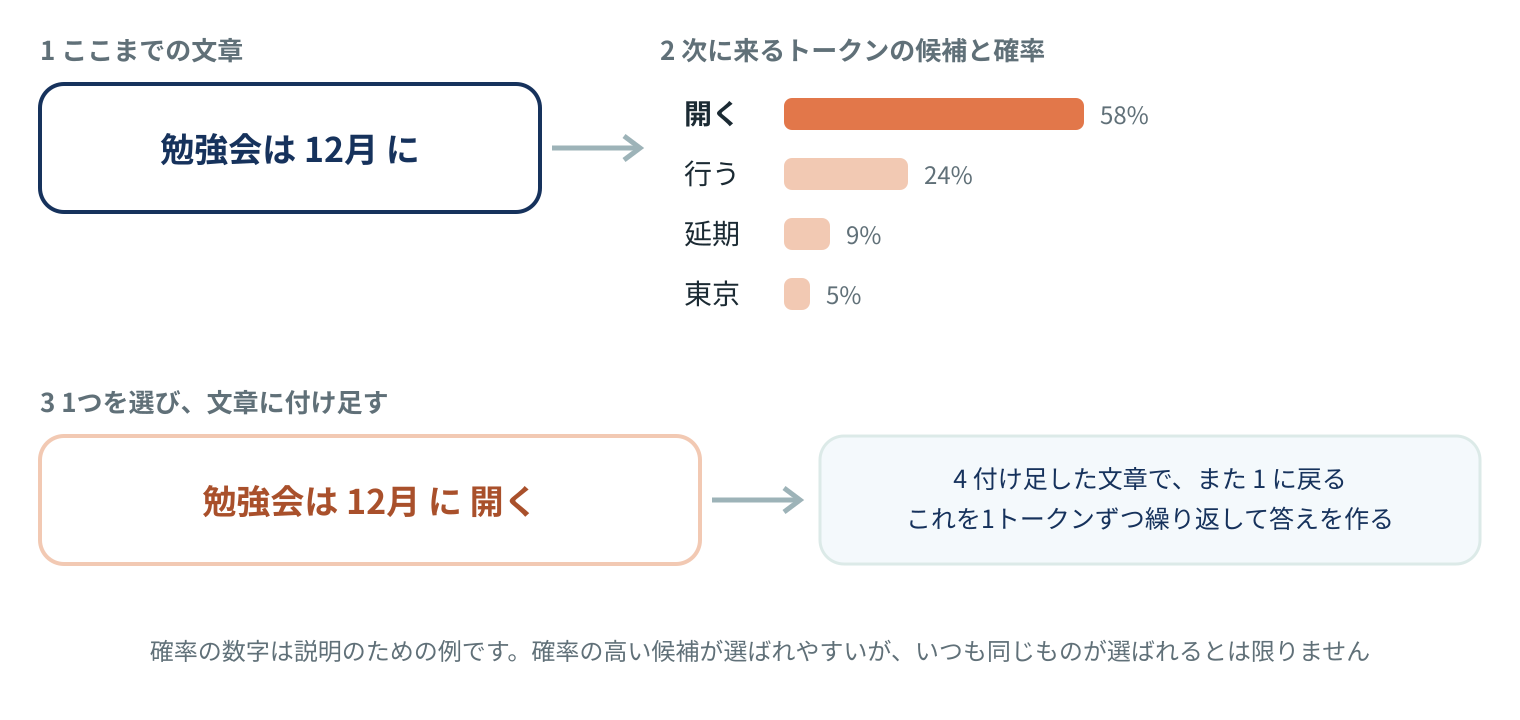
答えの文章は、この繰り返しでできています。ここから、2つのことが分かります。
1つは、答えが毎回少しずつ変わる理由です。候補の中から確率の高いものが選ばれやすいのですが、いつも同じものが選ばれるわけではありません。どれくらいばらつかせるかは「温度(temperature)」という設定で調整でき、高くすると多様な答えに、低くすると決まった答えに近づきます。ただし、温度を0にしても、まったく同じ答えになるとは限りません(出典[1])。この性質を非決定性と呼びます。
もう1つは、LLM は「正しいかどうか」を調べてから書いているのではないということです。選んでいるのは、それまでの文章に続くもっともらしいトークンです。これが、7節のハルシネーションにつながります。
4. LLM は、どうやって学ぶのか
次のトークンをうまく予測できるようになるまでに、LLM は大きく2つの段階で学びます。
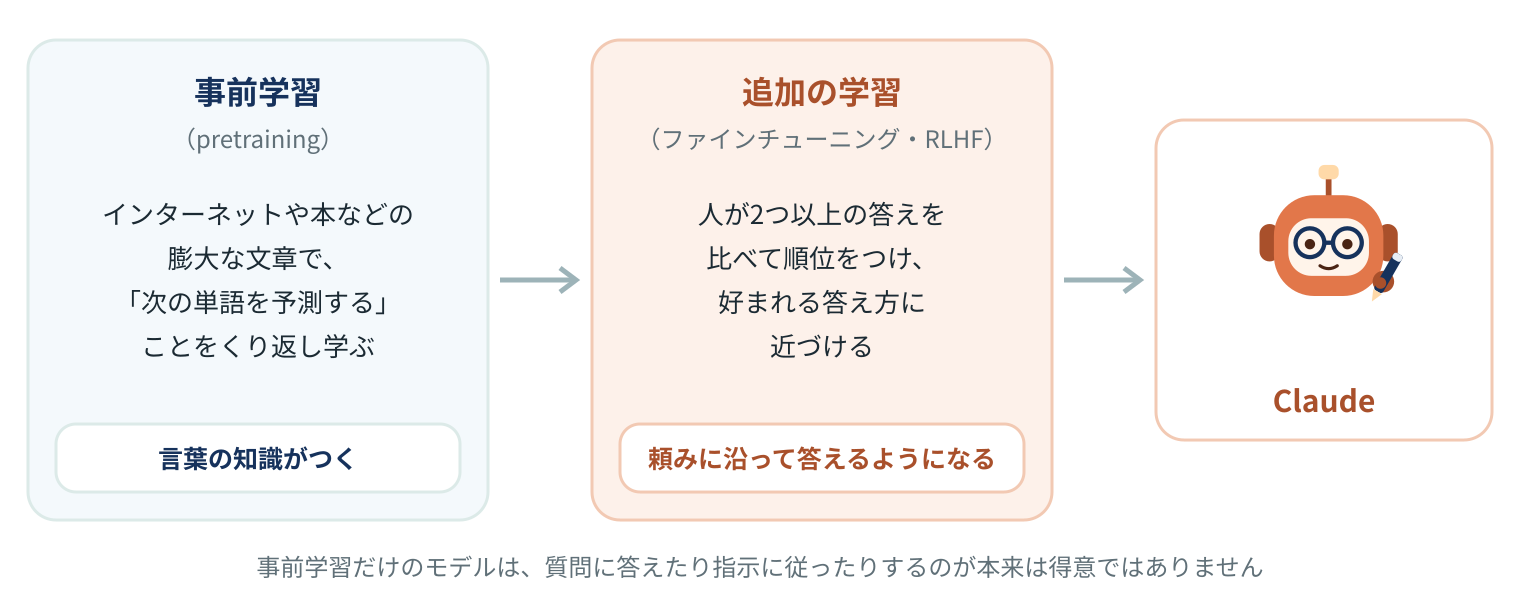
最初の事前学習では、ラベルの付いていない大量の文章を使って、それまでの文章から次の単語を予測するように学びます。ただ、事前学習だけのモデルは、質問に答えたり指示に従ったりすることが本来は得意ではありません(出典[1])。
そこで、追加の学習を行います。追加のデータでさらに学ばせることをファインチューニング(fine-tuning)といい、その方法の1つが RLHF です。RLHF では、人が2つ以上の答えを比べて順位をつけ、上位の答えに近い出力をするように学ばせます。公式の用語集でも、Claude は RLHF によって、より役に立つアシスタントになるよう学習されていると説明されています(出典[1])。
学習には、ある時点までの文章が使われます。そのため、LLM の知識には期限があります。期限より後の出来事は、学んでいません。Claude の公式のモデルの一覧にも、モデルごとに「信頼できる知識のカットオフ」が載っています(出典[3])。新人が見た「古い制度のまま答えていた」は、これが理由です。最新の情報が要るときは、Web 検索のように調べる道具を使わせるか、資料を渡します。
5. コンテキストウィンドウ:LLM の作業メモリ
LLM が答えを作るときに見ているのは、学習で身につけた知識と、もう1つ、いま渡されている文章です。これを収める場所がコンテキストウィンドウです。公式の用語集では、学習したデータの量ではなく、モデルの「作業メモリ」に当たると説明されています(出典[1])。
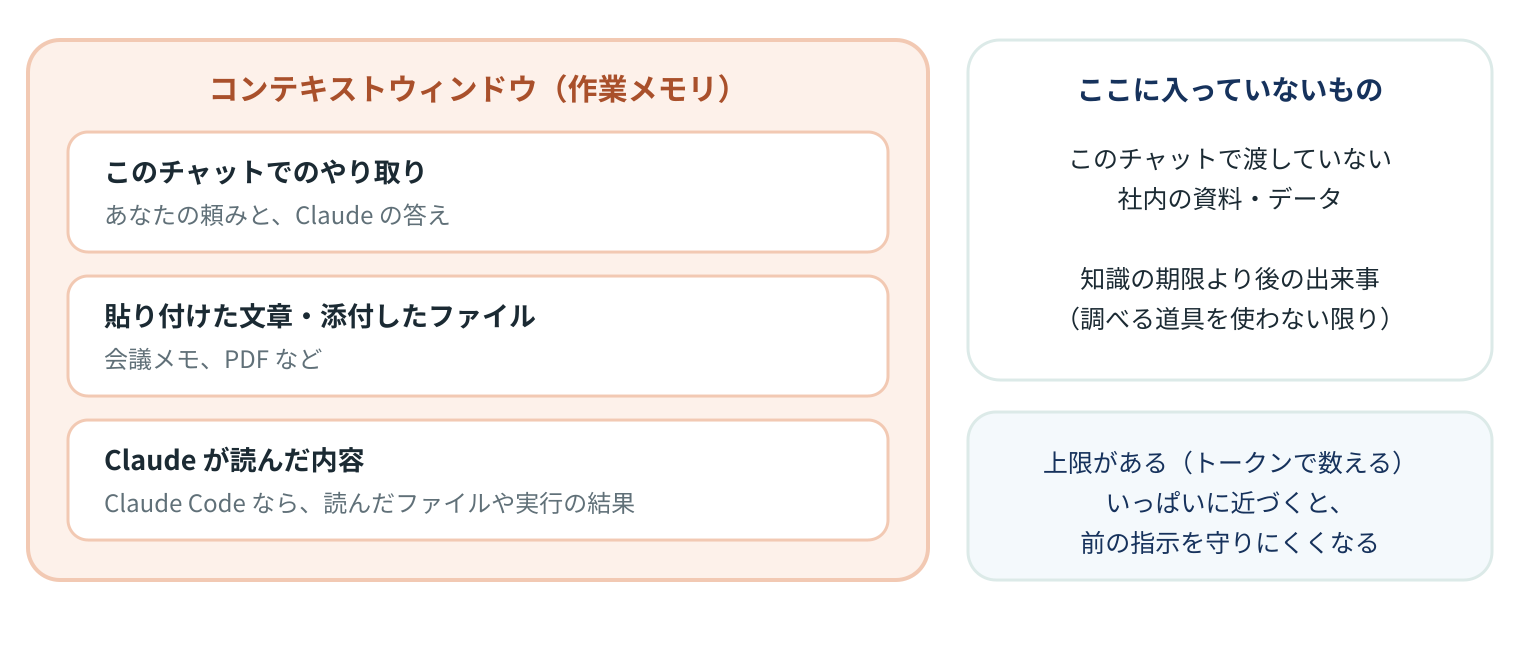
コンテキストウィンドウには上限があり、トークンの数で決まっています。現行の Claude のモデルは100万トークンです(出典[3]、2026年11月時点)。大きいほど長い資料や長い会話を扱えますが、小さいと、長い会話の中で一貫した答えを保ちにくくなります(出典[1])。
ここから分かるのは、渡していないことは、Claude には分からないということです。自社の売上の数字や、社内の決まりは、渡さなければコンテキストウィンドウに入りません。それでも聞かれれば、Claude はもっともらしい答えを書いてしまうことがあります。
6. 使用量:トークンは「使った量」にもなる
トークンは、LLM が文章を扱う単位であると同時に、どれだけ使ったかを数える単位でもあります。Claude の有料プランには、一定の期間にどれだけ使えるかの上限(使用量制限)があります。使用量は、会話の長さと複雑さ、使う機能、使うモデルなどで変わります。claude.ai、Claude Code、デスクトップアプリの使用量は、すべて同じ上限に数えられます(出典[4])。
上限は、一定の時間ごとにリセットされます(出典[5])。いまどれだけ使ったかは、claude.ai の「設定」の「使用量」で確かめられます(出典[5])。長い資料を何度も貼ったり、1つのチャットで話題を変えながら長く続けたりすると、それだけ使用量が増えます。この連載で Claude Code を使い始めると、1回の頼みで Claude がたくさんのファイルを読むので、使用量の感覚がもっと大事になります。Claude Code で使用量を確かめる方法は第1章で、アプリから Claude を呼ぶときの料金は「生成 AI アプリを作る」の章で扱います。
7. ハルシネーションが起きる理由と、減らし方
ここまでの3つを合わせると、ハルシネーションがなぜ起きるかが説明できます。
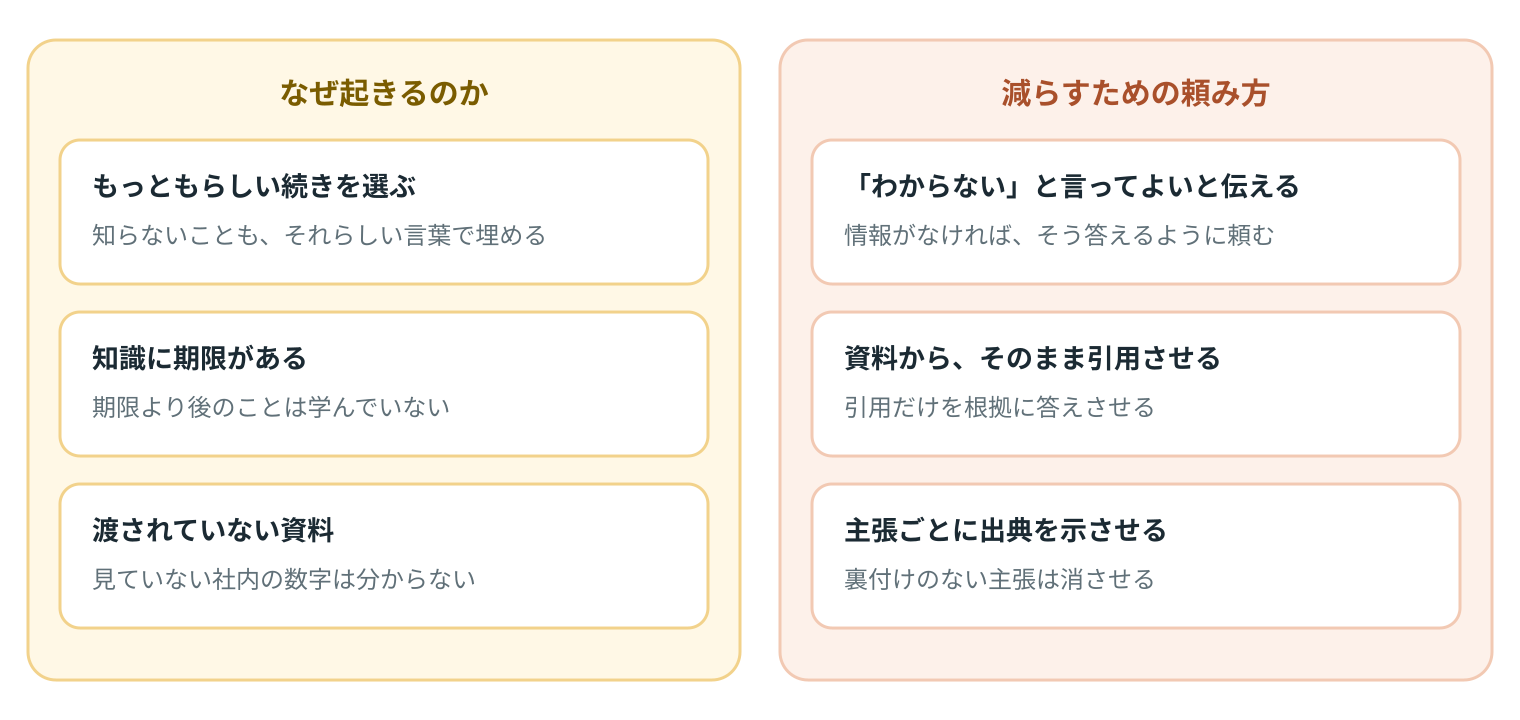
公式のドキュメントは、ハルシネーションを減らす基本の方法として、「わからない」と答えてよいとはっきり伝えること、長い資料ではまず関係する部分をそのまま引用させ、その引用だけを根拠に答えさせること、主張ごとに裏付けの引用を示させ、見つからない主張は消させること、を挙げています(出典[2])。0-1 で会議メモをまとめたとき、「書いていないことは足さない」と頼んだのは、この1つめの方法でした。
ただし、同じドキュメントは、こうした方法でハルシネーションは大きく減るが、なくなりはしないので、重要な判断では人が必ず確かめるように、とも書いています(出典[2])。副作用の件数や、添付文書の用量のように、間違えたときの影響が大きい内容は、元の資料と照らし合わせて確かめます。
8. やってみよう:claude.ai で2つの実験
しくみを、実際の Claude で確かめます。準備は要りません。0-1 と同じ claude.ai を使います。
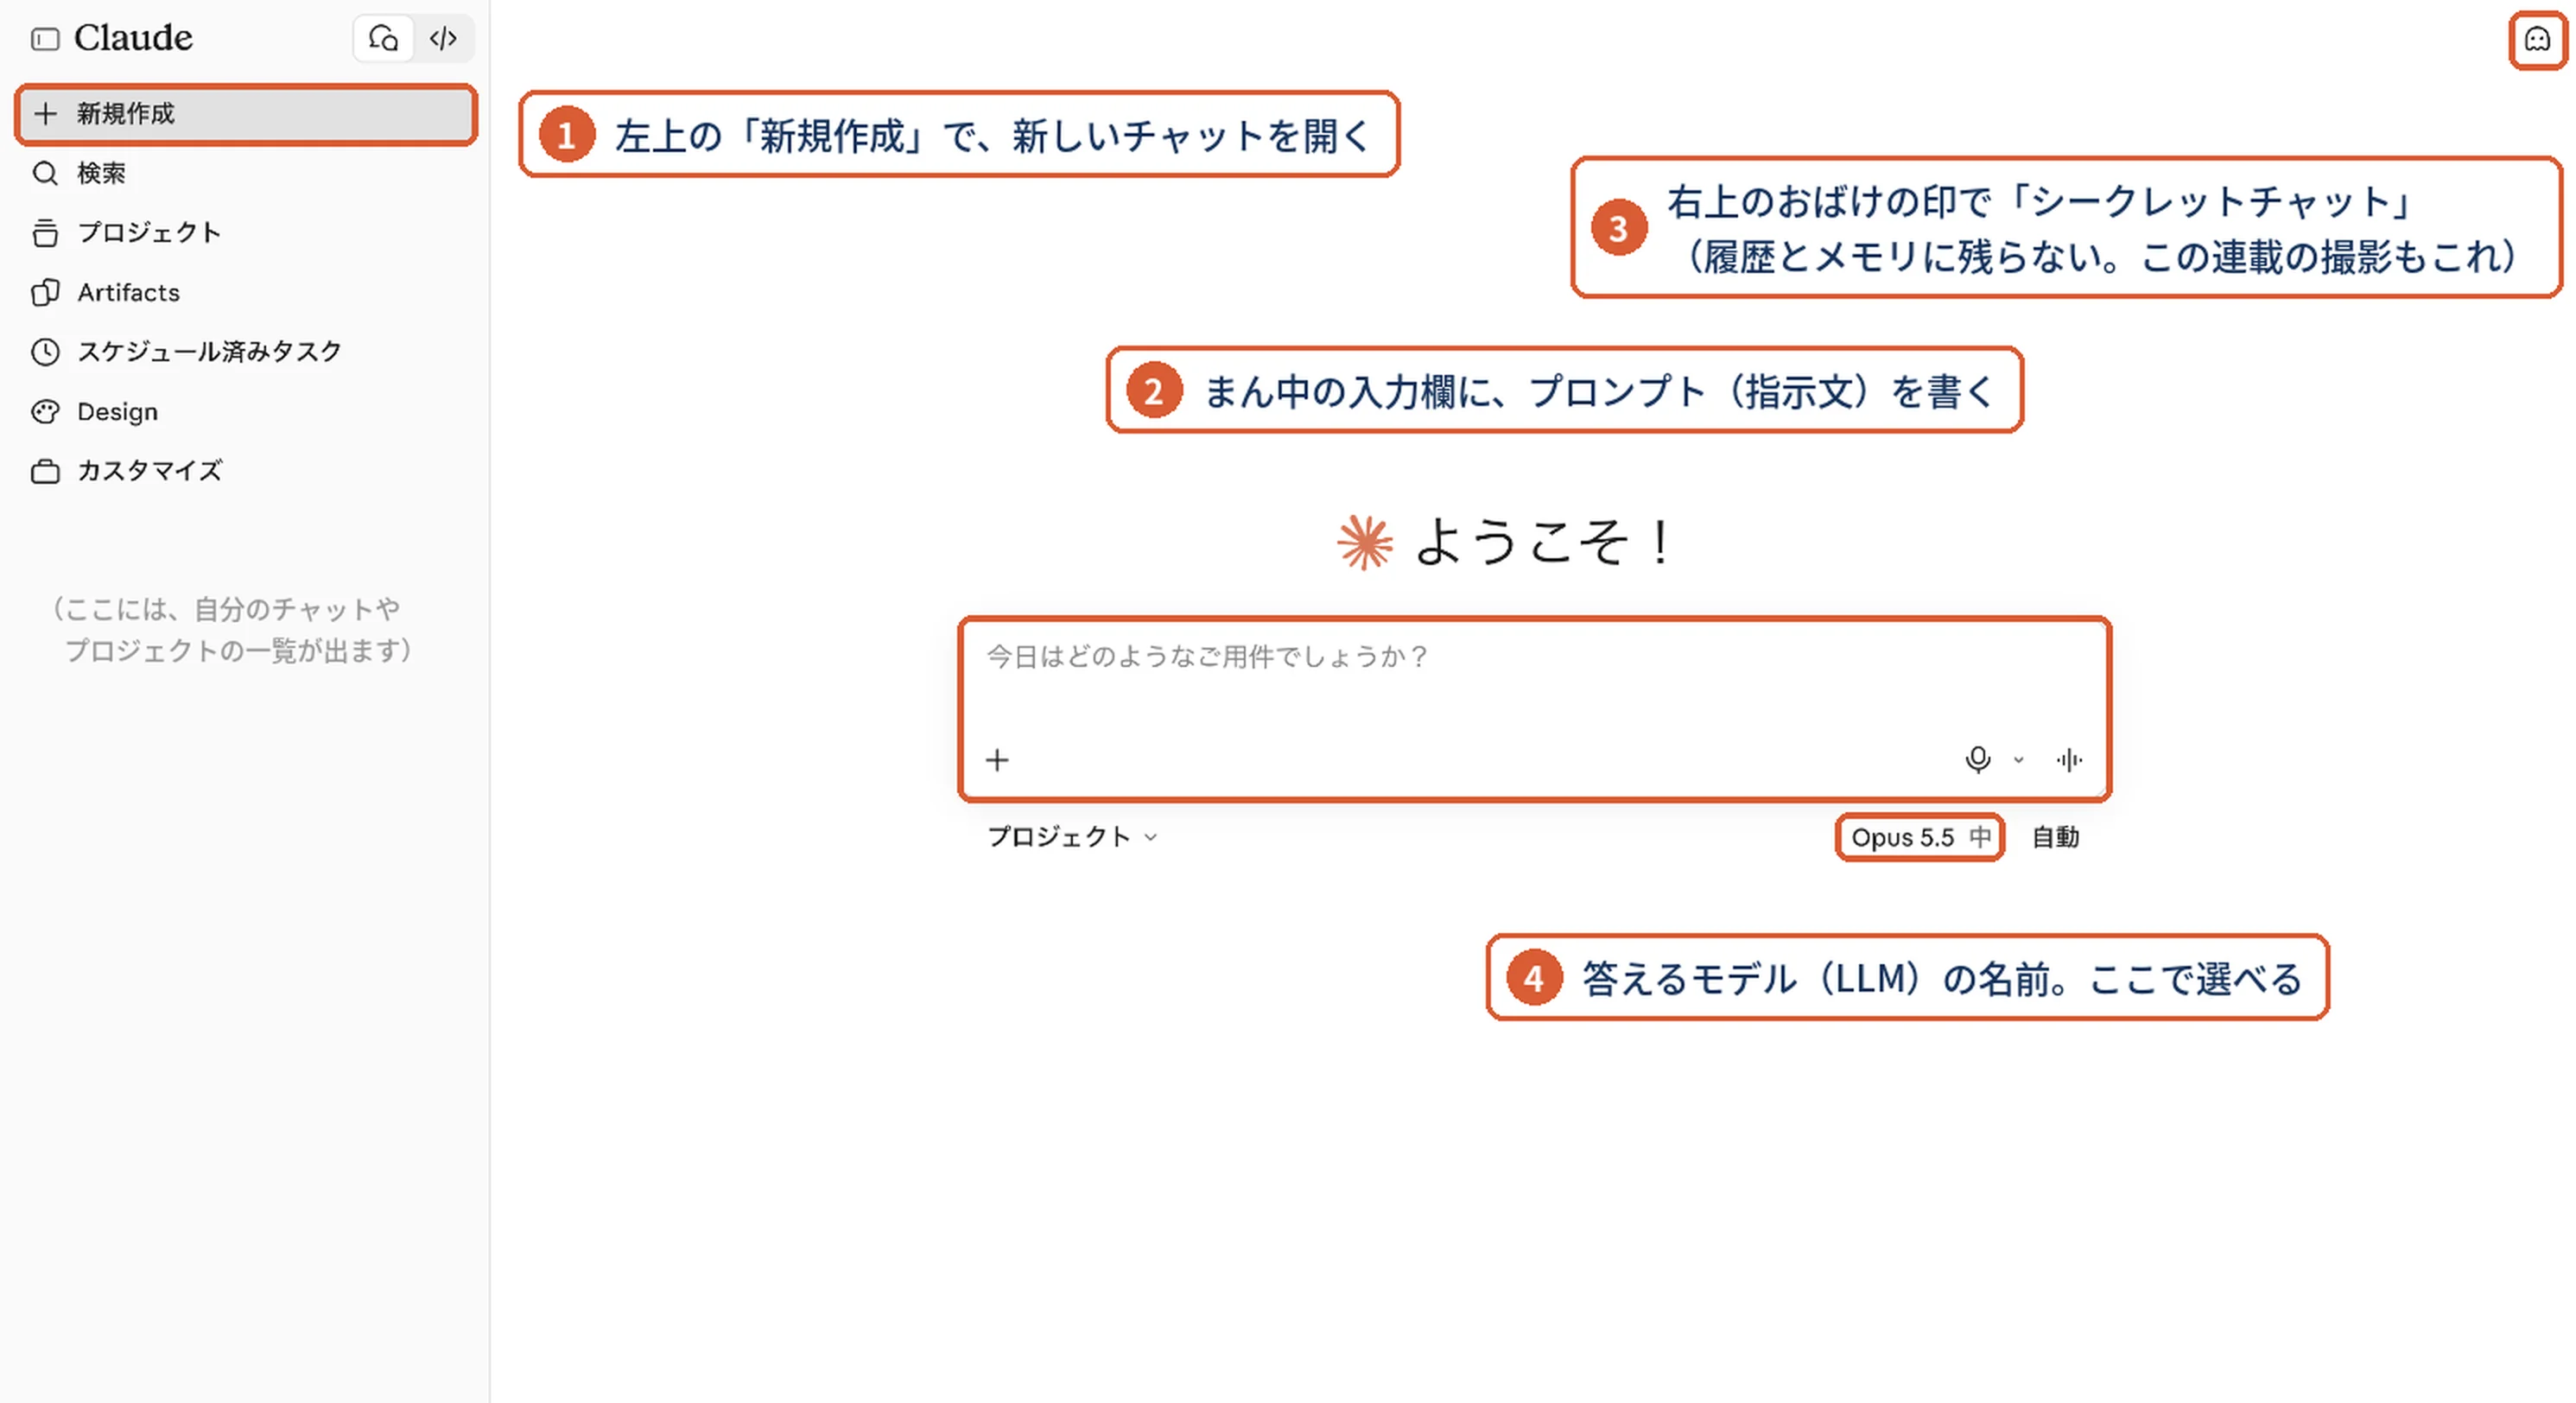
どこでやるか: ブラウザで claude.ai を開き、右上のおばけの印を押してシークレットチャットにします。シークレットチャットは履歴に残らず、ほかのチャットの内容も使われないので、実験の条件をそろえられます。
実験1:同じ頼みを2回送る(非決定性)
次の頼みを送ります。
社内の勉強会の案内文を、3文で書いてください。題材は「AI の使い方」、日時は12月10日 15時、場所は第2会議室です。
答えが出たら、答えのすぐ下にある丸い矢印のボタン(同じ頼みで、もう一度答えを作らせるボタン)を押し、2つの答えを見比べます。日時と場所は同じでも、言い回しや文の順番が変わっているはずです。3節の「次のトークンは、いつも同じものが選ばれるとは限らない」が、目に見える形になったものです。
実験2:知識の期限を聞く
新しいシークレットチャットを開き、次の頼みを送ります。
あなたの知識は、いつごろまでの情報をもとにしていますか。それより後のことを聞かれたら、どう答えますか。
Claude は、学習した情報に期限があることと、それより後のことは確かではないことを答えます。4節の「知識の期限」を、Claude 自身が説明してくれます。
9. よくある思い込み
思い込み:Claude は、インターネットを調べてから答えている
実際は:基本は、学習した知識と、渡された文章から答えを作っている。調べるのは、Web 検索などの道具を使ったときだけ
思い込み:同じ頼みには、いつも同じ答えが返る
実際は:次のトークンの選び方にばらつきがあるので、言い回しは変わる。温度を0にしても、まったく同じとは限らない
思い込み:ハルシネーションは、頼み方を工夫すればなくせる
実際は:大きく減らせるが、なくならない。影響の大きい内容は、人が元の資料で確かめる
思い込み:会話が長くなっても、最初に頼んだことは全部覚えている
実際は:コンテキストウィンドウには上限があり、いっぱいに近づくと前の指示を守りにくくなる
10. 理解度チェック
問1
LLM が答えの文章を作るしくみの説明として、最も適しているのはどれか。
- A. 質問に合う答えを、データベースから探して返している
- B. 答えの全文を先に決め、それを一度に書き出している
- C. それまでの文章から次のトークンを予測し、付け足すことを繰り返している
- D. インターネットを毎回検索し、見つけた文章をつなげている
正解:C。LLM は、それまでの文章を文脈として次のトークンを予測し、1つずつ付け足して答えを作ります(出典[1])。A のような決まった答えの表はありません。B のように全文を先に決めてはいません。D の検索は、Web 検索などの道具を使ったときだけです。
問2
Claude に「当社の先月の売上はいくらですか」と聞き、売上の資料は渡していない。起こりうることとして、最も注意すべきものはどれか。
- A. 資料にない数字を、もっともらしく答えてしまうこと
- B. 質問の意味が分からず、何も答えないこと
- C. 会社のシステムに入って、売上を調べにいくこと
- D. 先月の売上を、正確に答えること
正解:A。渡していない資料はコンテキストウィンドウに入っていないので、Claude には分かりません。それでも聞かれると、もっともらしい数字を書いてしまうこと(ハルシネーション)があります(出典[2])。B は起こりにくく、C は道具をつないでいなければできません。D は、資料がなければ期待できません。
問3
ハルシネーションを減らすための頼み方として、公式ドキュメントの説明に合っていないのはどれか。
- A. 情報が足りないときは「わからない」と答えてよいと伝える
- B. 長い資料では、関係する部分をまず引用させる
- C. 主張ごとに、裏付けとなる引用を示させる
- D. 頼み方を工夫すれば、人が確かめる必要はなくなる
正解:D。公式ドキュメントは、A・B・C の方法でハルシネーションは大きく減るが、なくなりはしないので、重要な判断では人が確かめるように、としています(出典[2])。
11. 現場で使うなら
いま仕事で AI に聞いていることを1つ思い浮かべて、その答えがどこから来ているかを考えてみてください。学習した知識から来ているのか、渡した資料から来ているのか、です。学習した知識から来ている答えには、期限とハルシネーションの心配があります。業務で使う答えは、なるべく資料を渡し、「資料に書いていないことは、わからないと答えて」と添えて頼みましょう。
ここまで見てきた LLM の弱点(知識に期限がある、渡していないことは分からない、もっともらしく間違える、答えがばらつく)は、LLM そのものを変えなくても、LLM の外側の仕組みで補えます。調べる道具を持たせる、資料を読ませる、結果を確かめさせる、といった仕組みです。この外側の仕組みを「ハーネス(harness)」と呼びます。次の回の主役です。
次回予告:0-4「AI 駆動開発とは」
- ハーネスとは何か
- AI 駆動開発で作れるもの
- バイブコーディングとの違い
出典(2026年11月17日に確認)
- Anthropic「用語集」Claude Platform Docs
- Anthropic「ハルシネーションを減らす」Claude Platform Docs
- Anthropic「モデルの概要」Claude Platform Docs
- Anthropic「使用量と長さの制限はどのように機能しますか?」Claude ヘルプセンター
- Anthropic「有料 Claude プランの追加使用量を管理する」Claude ヘルプセンター