Claude Code × Medical Application
【解説】Medicare Part D とは — 米国が無料公開する「処方医×薬剤」データの基礎
1. このページの目的
連載「Medicare Part D × Text-to-SQL」で使うデータを、記事本編とは切り離して解説する参照ページです。「Medicare って何?」「Part D の D は何?」「CSV に何が入っているの?」に、この1ページで答えられるようにします。連載の各記事からここにリンクします。
2. Medicare と Part D
2-1. Medicare は「65歳以上の公的保険」
Medicare は米国連邦政府が運営する公的医療保険で、主な対象は 65 歳以上の高齢者と、一部の障害者・末期腎不全の患者です。加入者は 6,000 万人を超え、米国の高齢者医療のほぼ全員をカバーしています。運営しているのが CMS(Centers for Medicare & Medicaid Services)で、日本でいえば厚生労働省保険局と社会保険診療報酬支払基金を足したような機関です。
2-2. 4つのパート
Medicare は給付の種類ごとに A〜D の 4 つに分かれています。
| パート | 何をカバーするか | 日本でいえば |
|---|---|---|
| Part A | 入院、施設療養、在宅ケア | 入院医療 |
| Part B | 外来診療、医師の診察、検査、外来で投与される薬 | 外来医療 |
| Part C(Medicare Advantage) | A+B(多くは D も)を民間保険会社が包括的に提供するプラン | 該当なし(民間委託型) |
| Part D | 薬局で受け取る処方薬 | 調剤 |
本シリーズが使うのは Part D=処方薬の給付です。2006 年に始まった比較的新しい制度で、実際の保険プランは民間保険会社が提供し、CMS が費用を補助して監督する仕組みになっています。単独の薬剤プラン(PDP)と、Medicare Advantage に付帯するプラン(MA-PD)の 2 種類があります。
2-3. 「Part D のデータ」に含まれる患者
Part D に加入している人の処方だけが入っています。つまり、主に 65 歳以上(+障害等で 65 歳未満の一部)で、病院の外来や入院で投与された薬(Part B)は含まれません。米国の全処方ではなく、「高齢者の外来処方」を見ているデータだと理解してください。
3. Medicare Part D Prescribers データセット
3-1. どんなデータか
CMS は 2015 年から、透明性政策の一環として Part D の請求データを 処方医 × 薬剤 × 年 で集計し、処方医の氏名付きで公開しています。データセットの正式名は「Medicare Part D Prescribers」で、2013 年分から毎年追加され、CY2024 分が 2026 年 5 月に公開されました。
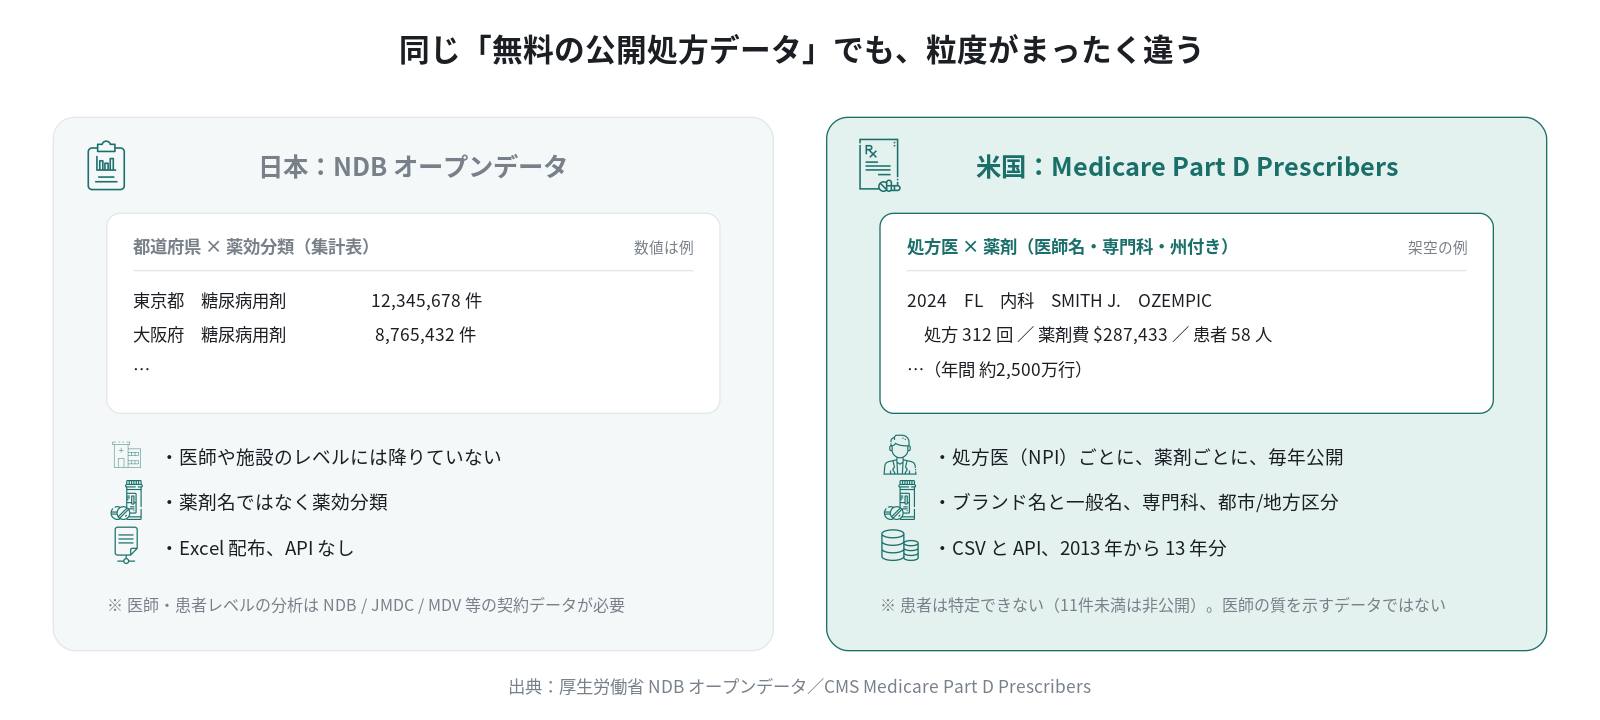
日本の NDB オープンデータが「都道府県 × 薬効分類」の集計表なのに対し、このデータは「医師 × 薬剤」まで降りています。医師は NPI(National Provider Identifier、全国一意の 10 桁 ID)で識別され、氏名・専門科・所在地が付きます。
3-2. 3つの表
| 表 | 1 行の単位 | 行数(1 年あたり) | 用途 |
|---|---|---|---|
| by Provider and Drug | 年 × 処方医(NPI) × 薬剤 | 約 2,500 万行 | 主表。「誰が、何を、どれだけ」 |
| by Provider | 年 × 処方医(NPI) | 約 110 万行 | 医師のプロファイル。ブランド/ジェネリック比率、オピオイド処方率、患者属性 |
| by Geography and Drug | 年 × 地域(全国・州) × 薬剤 | 約 9 万行 | 州別・全国の薬剤別集計。抑制のない全数 |
3 つとも CSV で data.cms.gov から誰でもダウンロードできます(API もあります)。主表は 1 年分で数 GB あるので、本シリーズでは BigQuery に入れて扱います。
3-3. 主要な列
主表(by Provider and Drug)の中心となる列です。列名は CSV の実名です。
| 列名 | 意味 | 注意 |
|---|---|---|
| Prscrbr_NPI | 処方医の NPI | 先頭 0 があるので文字列で扱う |
| Prscrbr_Last_Org_Name / Prscrbr_First_Name | 医師の姓・名(組織なら組織名) | |
| Prscrbr_State_Abrvtn | 州(略号) | 50 州+DC のほか、PR(プエルトリコ)や XX(不明)がある |
| Prscrbr_Type | 専門科 | 約 200 種。表記ゆれあり |
| Brnd_Name / Gnrc_Name | ブランド名/一般名 | 薬効クラスの列は 無い(自前の辞書が必要) |
| Tot_Clms | 請求数 | 新規+リフィル |
| Tot_30day_Fills | 30 日換算処方数 | 処方量の比較はこれを使う |
| Tot_Day_Suply | 総処方日数 | |
| Tot_Drug_Cst | 総薬剤費(USD) | リベート控除前。保険・患者・政府補助の支払合計 |
| Tot_Benes | 受給者数(ユニーク) | 1〜10 は空欄 |
| GE65_* | 65 歳以上の内訳 | 同じ指標が「65 歳以上だけ」で並ぶ |
by Provider(医師サマリ)には、さらに次のような列があります。
- ブランド/ジェネリック/その他の請求数と費用(Brnd_, Gnrc_, Othr_*)
- オピオイド、長時間作用型オピオイド、抗生物質、抗精神病薬(65 歳以上)の請求数と処方率
- 都市・地方区分(Prscrbr_RUCA:1 が大都市中心、10 が孤立地方)
- その医師の患者集団の属性:平均年齢、年齢階級、性別、人種、Medicaid 二重加入、平均リスクスコア
by Geography and Drug には、患者の自己負担額(LIS_Bene_Cst_Shr, NonLIS_Bene_Cst_Shr)が入っています。これは他の 2 表には無い情報です。
4. 読むときの約束事
4-1. 11 件未満は非公開(抑制)
患者のプライバシーを守るため、件数が 1〜10 の値は空欄になり、主表では 請求数 11 未満の医師 × 薬剤の行そのものが存在しません。さらに、他の内訳から逆算できてしまう値も隠されます(従属抑制)。抑制の理由は *(その値が 1〜10)と #(逆算防止)のフラグで示されます。
これが意味するのは、主表を足し上げても「その薬の全処方」にはならないということです。全数が欲しいときは by Geography and Drug を使います。本シリーズのアプリが「抑制で欠けている行数」を集計結果と一緒に表示するのは、この落とし穴を見えるようにするためです。
4-2. 費用はリベート控除前
Tot_Drug_Cst は、薬剤費+調剤料+税の「請求額」の合計で、製薬企業からプランへのリベート(値引き)は反映されていません。ブランド薬ほどリベートが大きいので、実際の負担額より高く見えます。「費用トップ 10」を見るときはこの前提を添えてください。
4-3. 処方量は Tot_30day_Fills で比べる
Tot_Clms(請求数)は 30 日分でも 90 日分でも 1 件です。処方量を比べるなら、各請求の日数を 30 で割って足した Tot_30day_Fills を使います。
4-4. 医師の質を測るデータではない
CMS 自身が明記しているとおり、このデータは個々の医師の医療の質を評価するものではありません。専門科や患者集団の違いで処方パターンは大きく変わります。本シリーズでも、医師個人のランキングを出すときは NPI 併記と免責を付けています。
5. できること、できないこと
できること
- 新薬の地域浸透:どの州、どの専門科、どの年に伸びたか
- 費用構造:総薬剤費の上位薬剤、ブランド/ジェネリック比率、州別の一人当たり費用
- 処方の集中度:上位何 % の医師がその薬の何 % を処方しているか
- 専門科ごとの処方パターン
- 都市と地方の差(RUCA)
- 患者の自己負担(州・薬剤単位)
できないこと
- 患者単位の追跡(治療ラインの切替、併用、アドヒアランス)— 集計済みで患者 ID が無い
- 月次の季節性 — 年次集計のみ
- 適応症別の分析 — 診断情報が無い
- 病院で投与される薬(Part B)や、Medicare 以外の保険の処方
- 医師の評価
6. 入手先
- データ本体:data.cms.gov の「Medicare Part D Prescribers」(3 表それぞれに年ごとの CSV と API)
- データ辞書:各表のページにある Data Dictionary(列の定義の正本)
- 手法の解説:Medicare Part D Prescribers Datasets: A Methodological Overview(抑制ルール、費用の定義、専門科の決め方)
本シリーズの GitHub リポジトリには、この辞書の日本語対訳(docs/data_dictionary.md)と、BigQuery に投入するスクリプトを置いています。
7. まとめ
- Medicare は米国の高齢者向け公的保険。Part D はその「薬局で受け取る処方薬」の給付
- CMS は Part D の請求を「処方医 × 薬剤 × 年」で集計し、医師名付きで無料公開している。日本にはこの粒度の公開データはない
- 3 つの表(医師×薬剤、医師、地域×薬剤)を使い分ける。11 件未満の抑制、リベート控除前の費用、30 日換算の 3 点を押さえれば、読み間違いの大半は防げる
次のステップ
このデータを SQL を書かずに探索する仕組みが Text-to-SQL です。解説ページ「Text-to-SQL とは」で、質問が SQL になり、結果が表・グラフ・地図のどれにでもなる流れを説明します。
出典
- CMS, Medicare Part D Prescribers - by Provider and Drug / by Provider / by Geography and Drug, Data Dictionary (data.cms.gov)
- CMS, Medicare Part D Prescribers Datasets: A Methodological Overview
- CMS, Medicare & You (Medicare の4つのパートの説明)
- 厚生労働省, NDB オープンデータ
コードは GitHub で公開しています: github.com/HerzLeben/medicare-partd-text-to-sql