Claude Code × Medical Application
【解説】Text-to-SQL とは — 日本語の質問が SQL になり、答えが好きな形で返るまで
1. このページの目的
連載「Medicare Part D × Text-to-SQL」の手法側の参照ページです。「Text-to-SQL って何?」「AI が書いた SQL をそのまま実行して大丈夫?」「グラフの種類は誰が決めるの?」に答えます。データ側の解説は「Medicare Part D とは」をご覧ください。
2. Text-to-SQL とは
Text-to-SQL は、人の言葉で書いた質問を、データベースに投げる SQL に変換する技術です。「GLP-1 受容体作動薬の州別処方数を 2022 年と 2024 年で比べて」と書けば、次のような SQL が生成され、実行され、結果が返ってきます。
SELECT prscrbr_geo_desc AS state,
       SUM(IF(year = 2022, tot_30day_fills, 0)) AS fills_2022,
       SUM(IF(year = 2024, tot_30day_fills, 0)) AS fills_2024
FROM partd.geo_drug
WHERE prscrbr_geo_lvl = 'State'
  AND gnrc_name IN ('Semaglutide', 'Dulaglutide', 'Liraglutide', 'Tirzepatide')
  AND year IN (2022, 2024)
GROUP BY state
ORDER BY fills_2024 DESC
研究自体は 20 年以上前からありますが、実用になったのはここ数年です。理由は大規模言語モデル(LLM)が、テーブル定義を読んで文脈に合った SQL を書けるようになったからです。とくに「GLP-1 受容体作動薬」を薬剤名の集合に展開するような、ドメイン知識を要する変換ができるようになった点が大きいです。
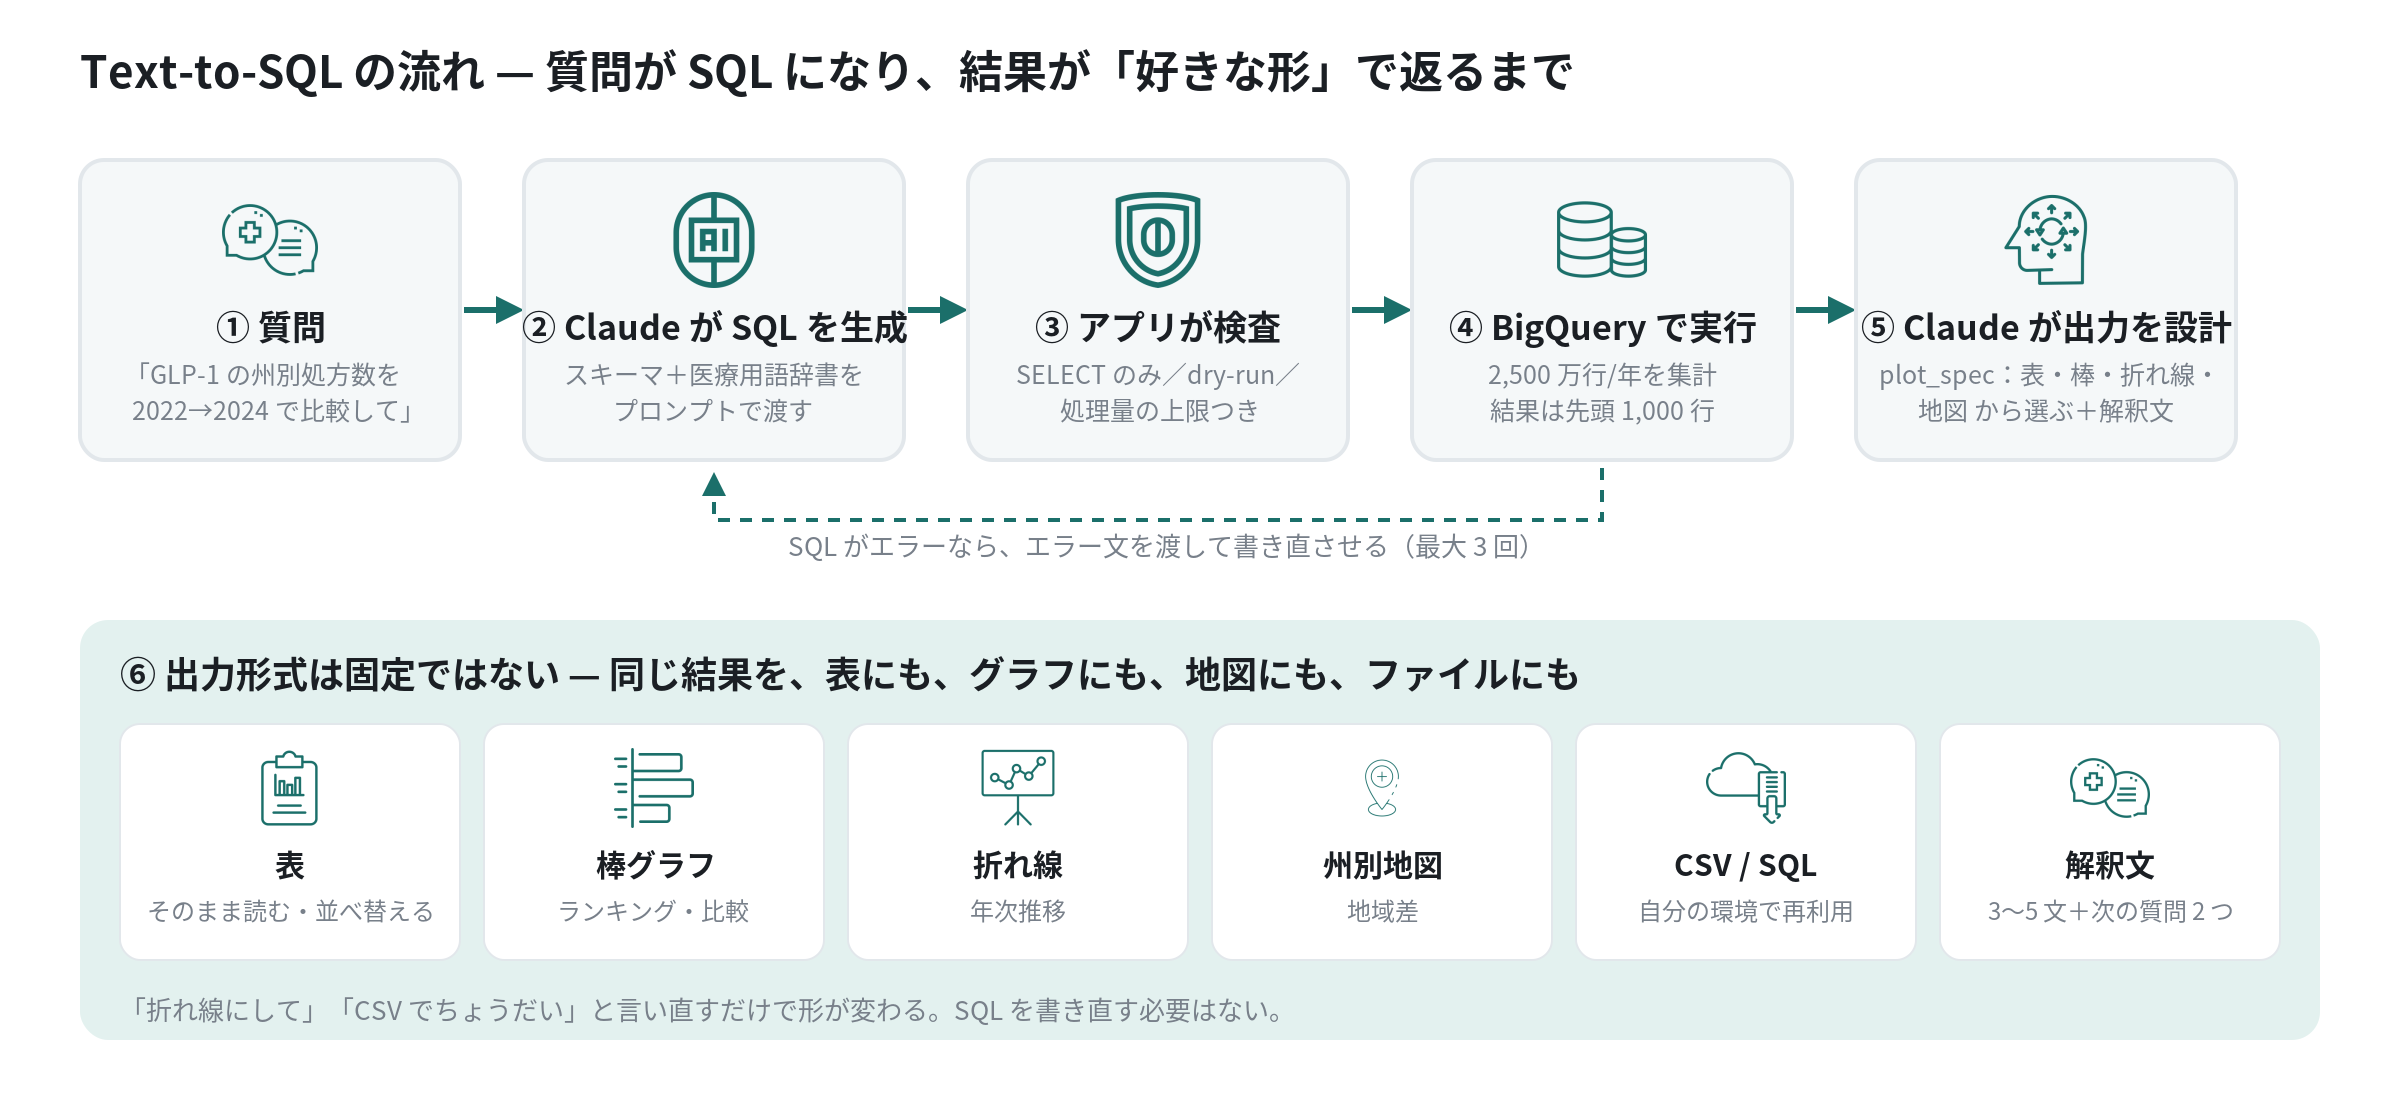
3. 仕組み — 6 つのステップ
3-1. 質問
利用者は日本語(または英語)で質問を書きます。アプリ側では、年・州・専門科・薬効クラスのフィルタで範囲を先に絞ることもできます。フィルタは質問文の一部として Claude に渡されます。
3-2. Claude が SQL を生成
Claude に渡すのは質問だけではありません。システムプロンプトに次の 3 つを入れておきます。
| 渡すもの | 中身 | 役割 |
|---|---|---|
| スキーマ | 3 つのテーブルの列名・型・意味 | 存在しない列を使わせない |
| 医療用語辞書 | 「処方数」→ tot_30day_fills、「GLP-1」→ 薬剤名 4 つ、「精神科」→ Prscrbr_Type の表記 3 種 など | 業界の言い方を列と値に翻訳する |
| 例題(few-shot) | 質問と正解 SQL のペアを 5 本 | 集計の作法(抑制の扱い、年の比較の書き方)を示す |
このプロンプトは毎回同じなので、Anthropic API の Prompt caching を使って 2 回目以降は読み直さずに済ませます。
3-3. アプリが検査
生成された SQL をそのまま実行しません。実行前にアプリが機械的に検査します。
SELECTまたはWITHで始まるものだけ通す。DELETE、UPDATE、DROPなどを含めば拒否partd.以外のデータセットを参照していれば拒否SELECT *はエラーを返して書き直させる(列を明示させる)- BigQuery の dry-run で処理バイト数を見積もり、上限を超えるクエリは実行しない
この検査は LLM ではなくコードで行います。「AI に安全性を頼まない」のが設計の基本です。
3-4. BigQuery で実行、失敗したら自己修正
検査を通った SQL を BigQuery で実行します。列名の間違いや型のエラーで失敗したら、エラーメッセージをそのまま Claude に返して書き直させます(最大 3 回)。人が SQL を書くときの試行錯誤を、そのまま自動化しています。
3-5. Claude が出力を設計
結果の表(先頭 1,000 行)を受け取った Claude は、次の 2 つを返します。
- plot_spec:グラフの種類(表・棒・折れ線・州別地図)、x 軸と y 軸に使う列、色分けの列
- 解釈文:3〜5 文の読み取りと、次に聞くとよい質問 2 つ
グラフの種類を Claude が選ぶのは、結果の形(州が並んでいるなら地図、年が並んでいるなら折れ線)を見て判断できるからです。
3-6. 出力形式は固定ではない
ここが Text-to-SQL のいちばん誤解されやすい点です。出力の形は SQL とは独立に決まります。 同じ結果を、表にも、棒グラフにも、折れ線にも、地図にも、CSV にもできます。
利用者は「折れ線にして」「地図で見せて」「CSV でちょうだい」と言い直すだけで形が変わります。SQL を書き直す必要はなく、plot_spec が変わるだけです。逆に「同じ形で 2023 年も足して」と言えば、今度は SQL だけが変わります。
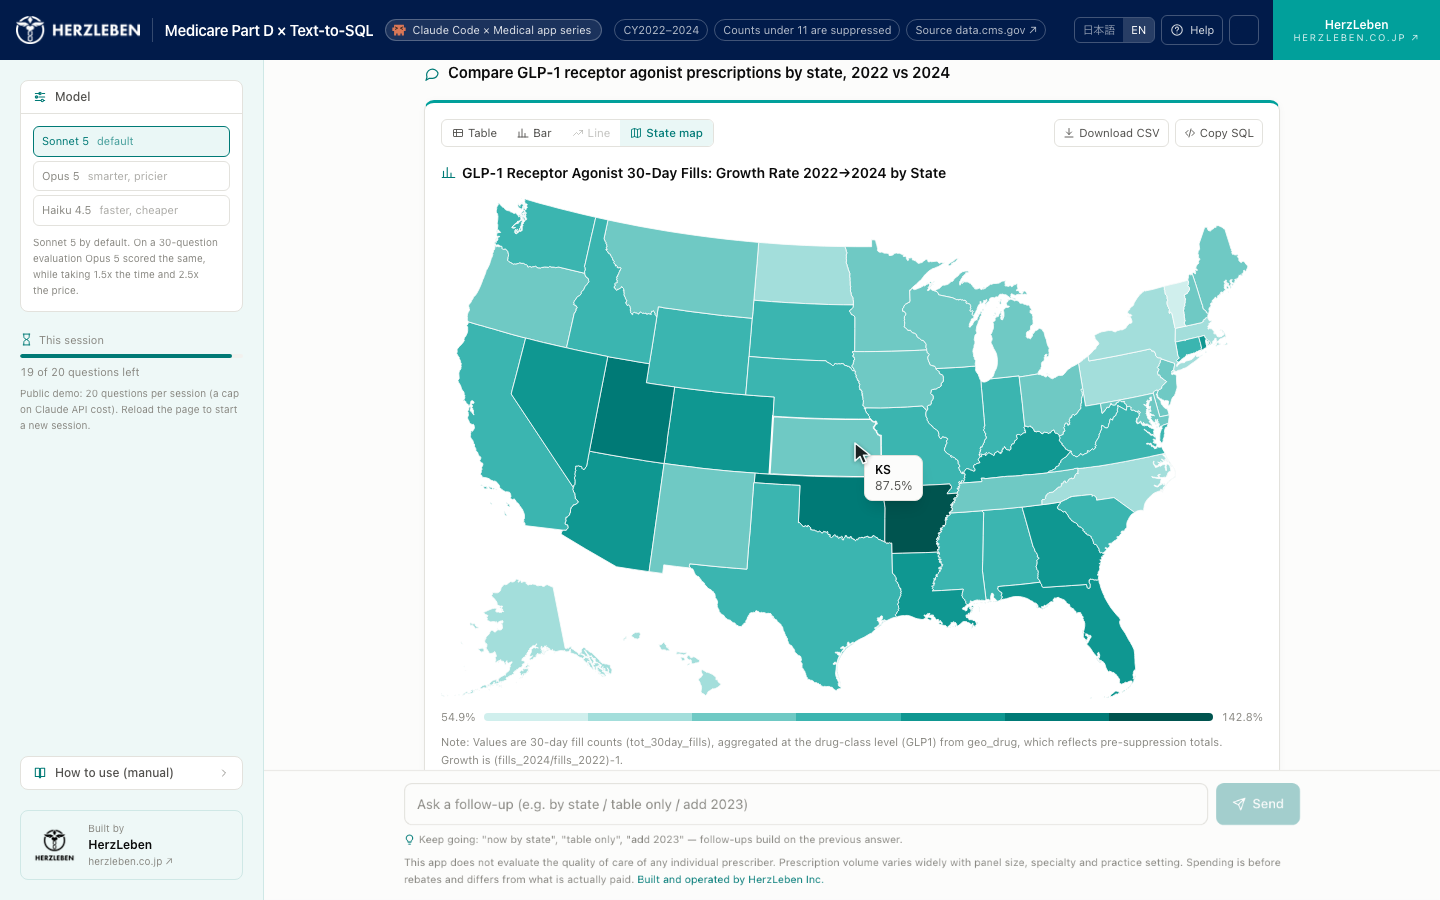
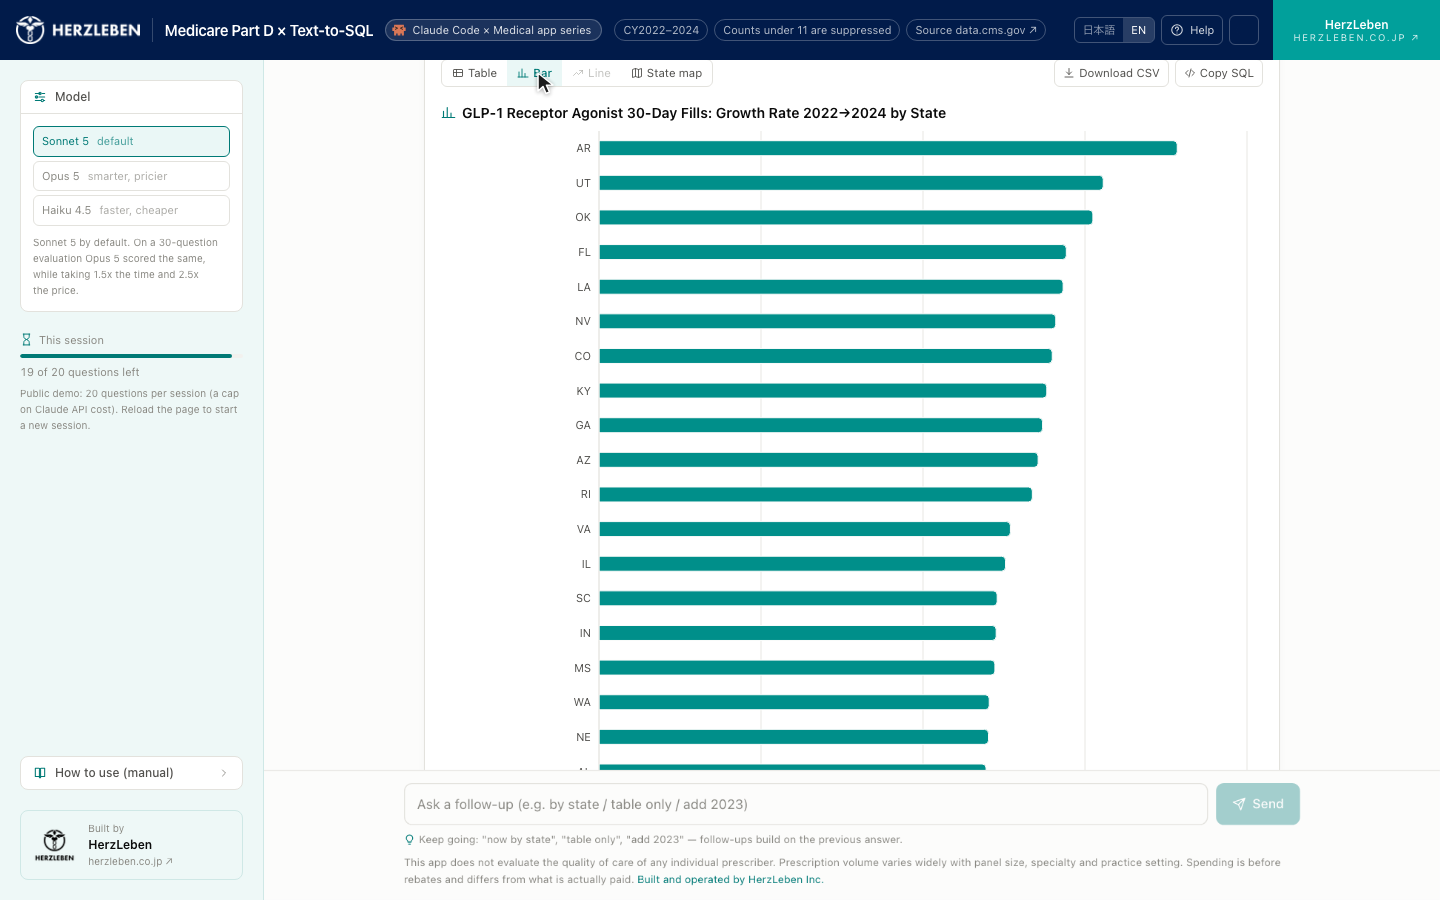
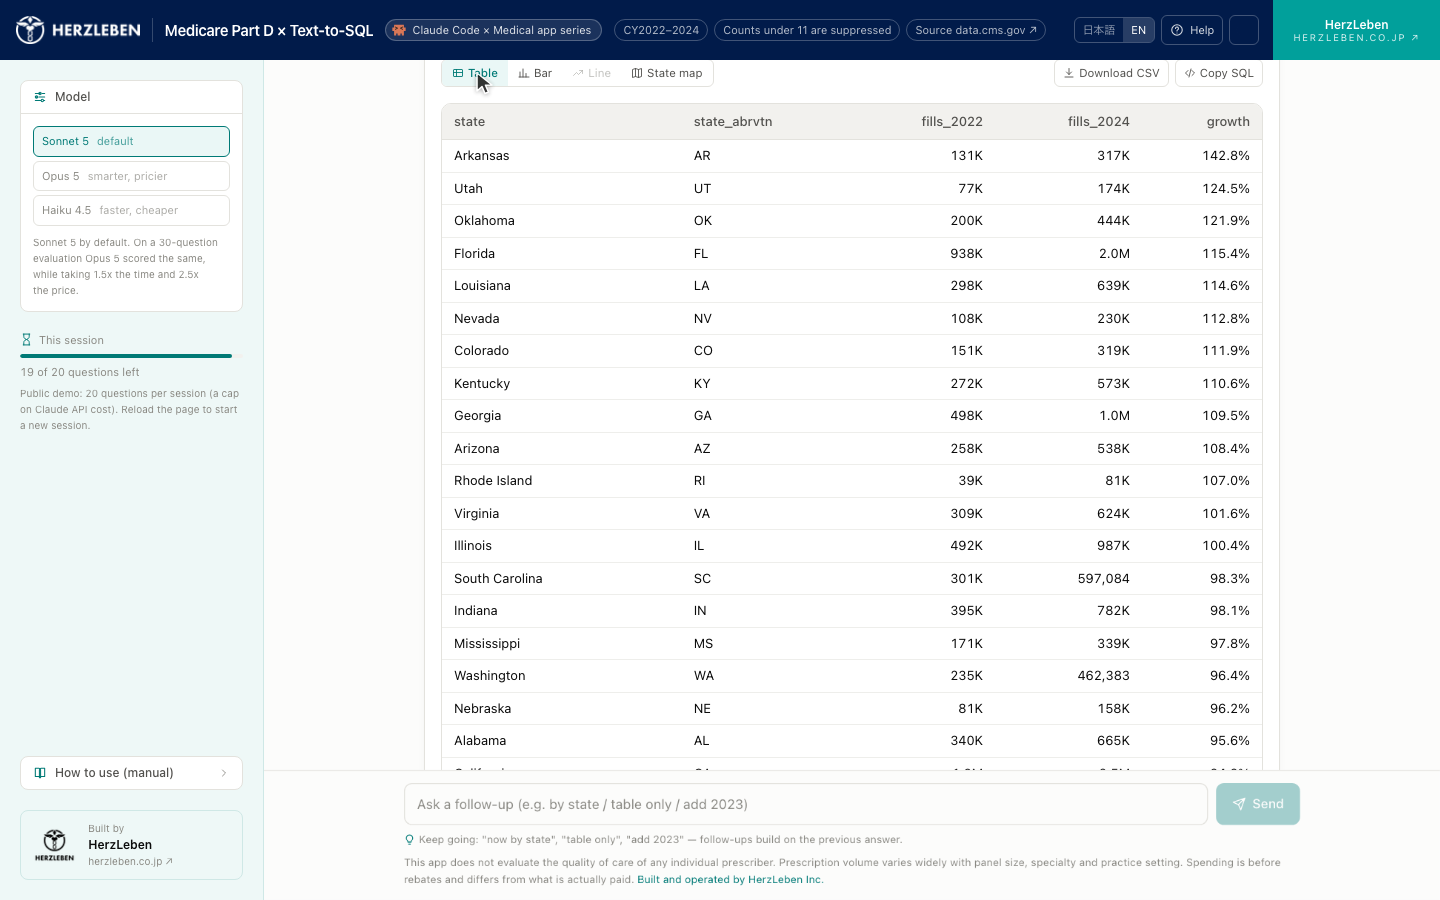
本シリーズのアプリでは、生成された SQL 自体も折りたたみで表示し、コピーできます。これも「出力の一つ」です。SQL を持ち帰れば、自分の BigQuery でも、社内の別のデータベースでも同じ集計を再現できます。
4. tool use — 「SQL 実行」と「可視化仕様」を別のツールにする
上の流れを実装する鍵が Claude の tool use です。Claude に「この関数を呼べる」と教えておくと、Claude は文章ではなく、関数呼び出しの形(JSON)で返答します。本シリーズのアプリでは 2 つだけ定義しています。
{
  "name": "run_sql",
  "description": "Run a read-only BigQuery SQL and return up to 1000 rows",
  "input_schema": {
    "type": "object",
    "properties": { "sql": { "type": "string" } },
    "required": ["sql"]
  }
}
{
"name": "plot_spec",
"description": "Describe how to visualize the last result",
"input_schema": {
"type": "object",
"properties": {
"kind": { "enum": ["table", "bar", "line", "choropleth_state"] },
"x": { "type": "string" },
"y": { "type": "string" },
"color": { "type": "string" }
},
"required": ["kind"]
}
}ツールを 2 つに分けているのは、SQL が実行される前にアプリが割り込めるようにするためです。Claude が run_sql を呼ぶ → アプリが検査して実行する → 結果を Claude に返す → Claude が plot_spec を呼ぶ、という順番になります。Claude が直接データベースに触ることはありません。
5. 精度をどう測るか
Text-to-SQL は「動く」と「正しい」が別です。SQL がエラーなく実行されても、集計の意味が違っていれば誤りです。本シリーズでは 30 問の評価セットを作り、次の 3 段階で判定しています。
| 判定 | 意味 |
|---|---|
| 実行成功 | SQL がエラーなく実行された |
| 結果一致 | 人が書いた正解 SQL と同じ結果になった(順序・丸めは無視) |
| 解釈妥当 | 解釈文が結果と矛盾していない |
よくある失敗は、請求数(tot_clms)と処方量(tot_30day_fills)の取り違え、抑制で欠けた行を無視した「合計」、専門科の表記ゆれの取りこぼしの 3 つです。いずれも用語辞書と few-shot で潰せます。精度の実測値は Part 3 で公開します。
6. 社内データに展開するときの注意
公開データで固めたプロンプト・ガード・評価方法は、社内データにもそのまま持ち込めます。ただし次の 3 点は先に決めておく必要があります。
- どのテーブルを見せるか:スキーマに入れたテーブルしか Claude は知りません。逆に、入れたものは全部質問できます
- 誰が実行するか:BigQuery の実行権限はアプリのサービスアカウントに付きます。利用者ごとの行レベル制御が要るなら、別途設計が必要です
- ログをどこに残すか:質問文、生成 SQL、処理バイト、所要時間を必ず記録します。監査と、精度改善の両方に使います
7. まとめ
- Text-to-SQL は「質問 → SQL」の変換。LLM がスキーマと用語辞書を読んで書く
- 生成 SQL はコードで検査してから実行する。失敗はエラー文を返して自己修正させる
- 出力の形(表・グラフ・地図・CSV・解釈文)は SQL とは独立に決まる。言い直すだけで変えられる
- 「動く」と「正しい」は別。評価セットで測る
次のステップ
連載本編の Part 2 では、この仕組みを Claude Code に実装させる過程を、用語辞書とツール定義の実物と一緒に見せます。
出典
- Anthropic, Claude Developer Platform — Tool use / Prompt caching (docs.claude.com)
- Google Cloud, BigQuery — Dry run queries / maximum_bytes_billed
- CMS, Medicare Part D Prescribers Data Dictionary (data.cms.gov)
コードは GitHub で公開しています: github.com/HerzLeben/medicare-partd-text-to-sql