Claude Code × Medical Application
【Claude Code】Medicare Part D × Text-to-SQL Part0:全体像とできること
1. はじめに
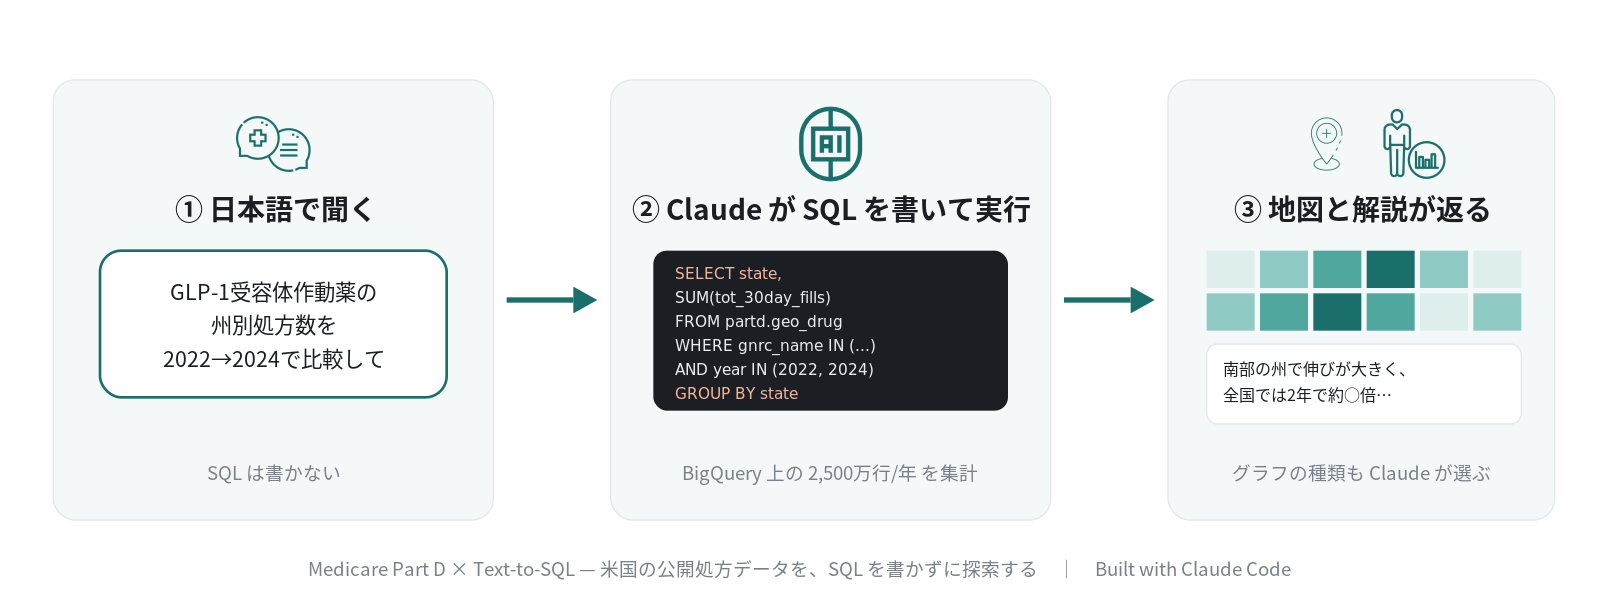
「SQL を書かずに、米国の処方データ 2,500万行を日本語で探索する」 — そういうアプリを Claude Code で作り、公開するまでを全5回で解説します。連載「Claude Code × Medical Application」の第1作、「Medicare Part D × Text-to-SQL」です。コードは GitHub で公開し、読者が自分の環境で動かせるようにします。
1-1. 完成イメージ
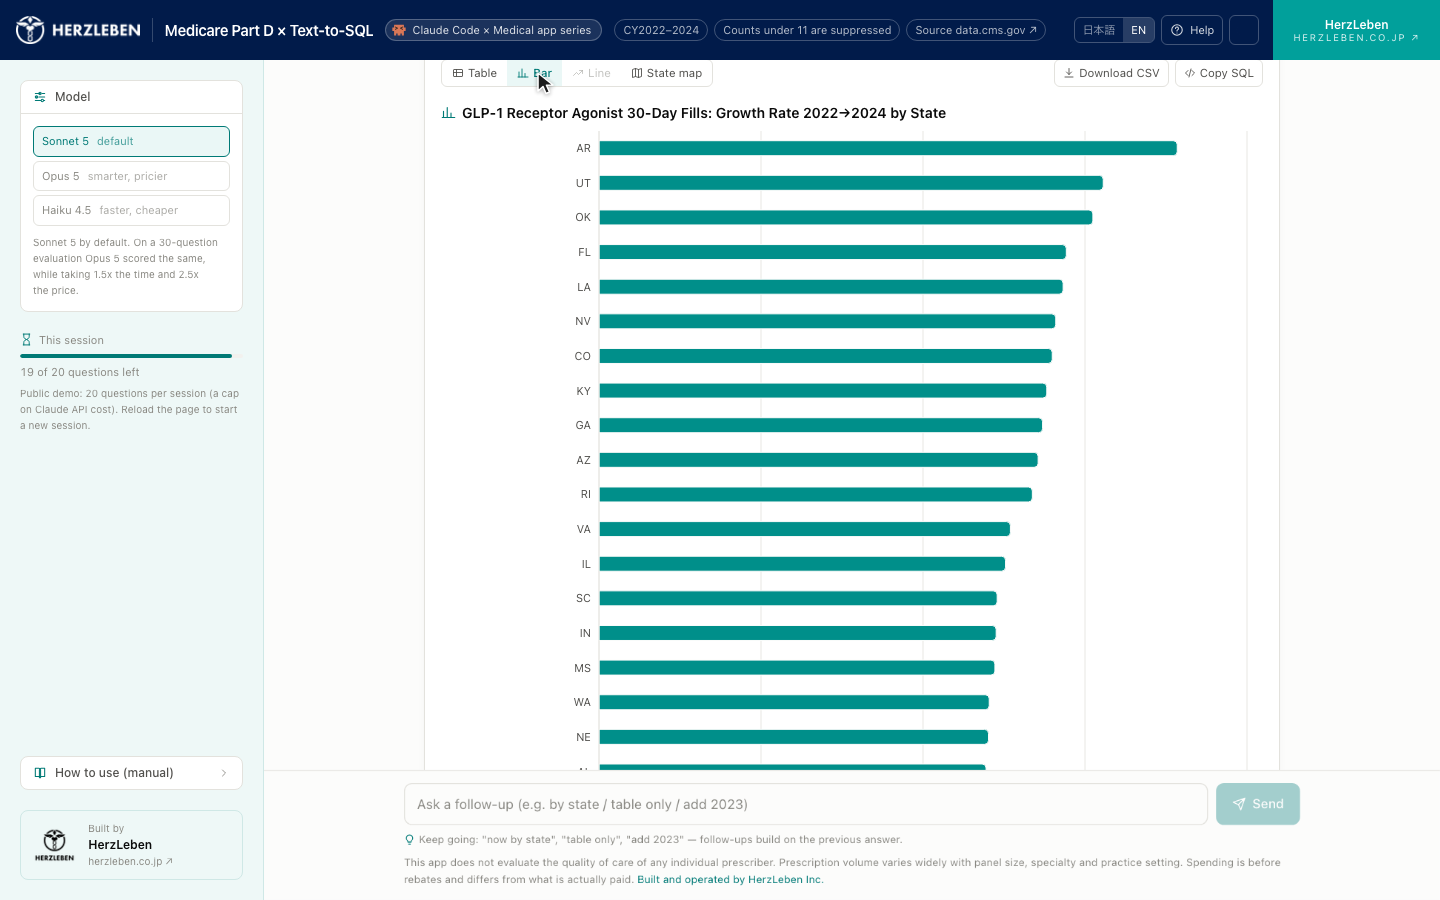
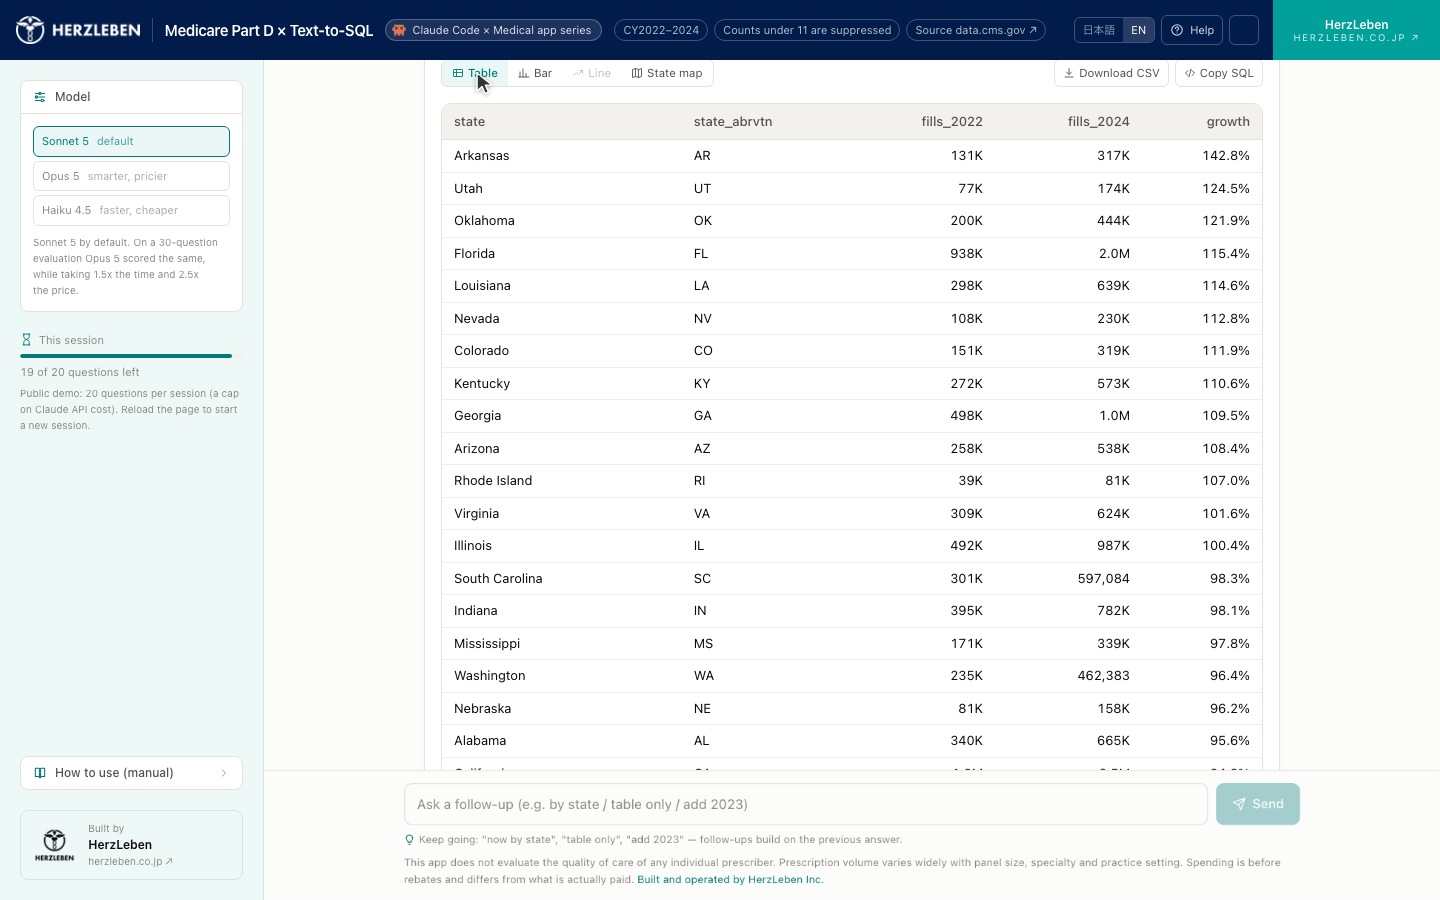
1-2. このシリーズで分かること
| Part | 内容 | 動画 |
|---|---|---|
| 0 | 全体像とできること(本記事) | アプリ操作動画 |
| 1 | Medicare Part D 処方データの基礎 — 何が入っていて、何が入っていないか | データを実際に開く動画 |
| 2 | Claude に SQL を書かせる — 医療用語辞書と、生成 SQL を無条件に実行しないための2つのツール | Claude Code の作業画面 |
| 3 | 画面を作り、3つの質問で試す — UI の構成と、30問で測った精度 | 評価を回す画面 |
| 4 | 自分の GCP に公開する — Cloud Run の手順(任意) | GCP 設定の実況 |
想定読者は、製薬・医療機器企業の RWE、メディカルアフェアーズ、データサイエンス、DX 推進部門の方と、ヘルスケア IT のエンジニアです。SQL は「読めば分かる」程度で十分、Google Cloud は未経験でも追えるように書きます。
2. なぜ米国のオープン医療データなのか
2-1. 日本には「医師×薬剤」の公開データがない
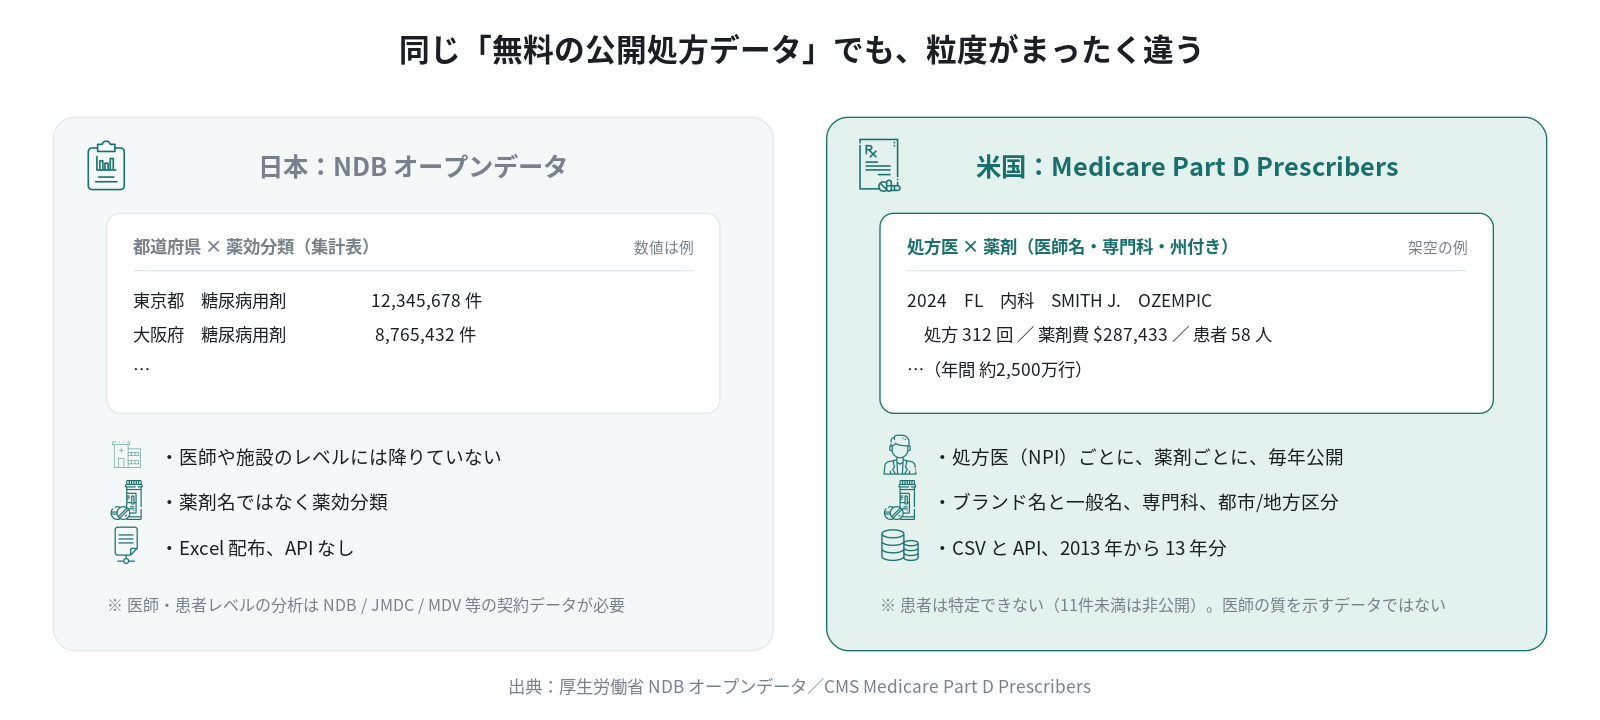
日本で医師や患者のレベルまで分析しようとすると、NDB・JMDC・MDV などの契約データが必要で、「試しに触ってみる」ことはできません。誰でも取れる NDB オープンデータは、都道府県 × 薬効分類の集計表を Excel で配る形です。
米国の CMS(Centers for Medicare & Medicaid Services、日本でいえば厚労省保険局に近い機関)は、公的保険 Medicare の薬剤給付 Part D の請求を、処方医 × 薬剤ごとに年次集計し、医師名付きで公開しています。2015年に始まった透明性政策の一環で、2026年5月に CY2024 分が出ました。2013年以降の13年分が CSV で誰でも取得できます。
「医師レベルの処方データを、無料で、誰でも」という条件がそろっているのは米国だけです。この事実を知ってもらうことが、本シリーズの最初の目的です。
2-2. このデータで何が見えるか
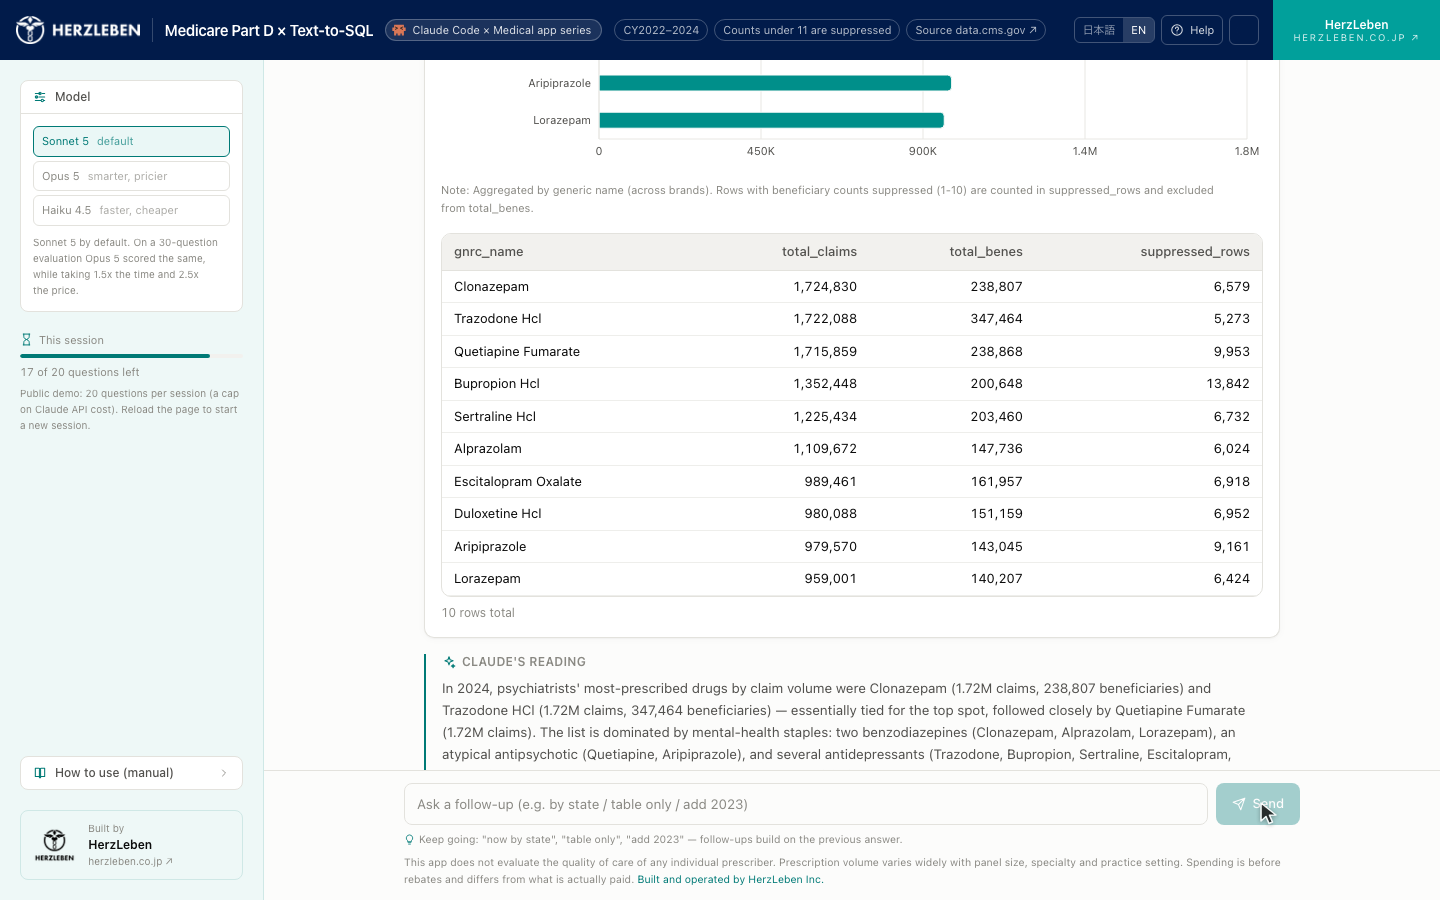
- 新薬の地域浸透 — GLP-1 受容体作動薬や DOAC の処方量が、どの州で、どの専門科で、どの年に伸びたか
- 費用構造 — 総薬剤費の上位薬剤、ブランド/ジェネリックの比率、州ごとの一人当たり薬剤費
- 処方の集中度 — 上位何%の処方医が、その薬剤の何%を処方しているか
- 専門科ごとの処方パターン — 精神科医が最も処方する薬剤、内科医のオピオイド処方率の分布
- 都市と地方の差 — RUCA(都市・地方区分)で切ったジェネリック率や処方量
一方で、患者単位の追跡(治療ラインの切替、併用、アドヒアランス)、月次の季節性、適応症別の分析(診断情報がない)はできません。詳細と限界は Part1 で扱います。
2-3. 製薬・ライフサイエンス業界での使いどころ
米国データなので日本市場の分析には直接使えません。それでも、次の3つの場面で価値があります。
① グローバル製品の米国動向を自分で確認する。 本社や米国法人から届く数字を、公開データで裏取りする。報道では「急伸」としか書かれないことを、処方量と処方医数の実数で見る。
② RWD 分析の練習台にする。 契約が要るデータで試行錯誤する前に、同じ構造(請求ベース、集計済み、抑制あり)の公開データで、コホート定義や集計の癖を身につける。抑制値の扱い、ブランド名と一般名の名寄せ、専門科の表記ゆれといった実務の課題がそのまま出てきます。
③ 生成 AI をデータ分析に組み込む設計を、公開データで検証する。 社内データでいきなり Text-to-SQL を試すと、データガバナンスの議論が先に来て前に進みません。公開データなら、プロンプト設計、ガードの入れ方、精度の測り方を先に固められます。本シリーズはこの③を主題にしています。
3. 本シリーズで作成するアウトプット
3-1. アプリでできること
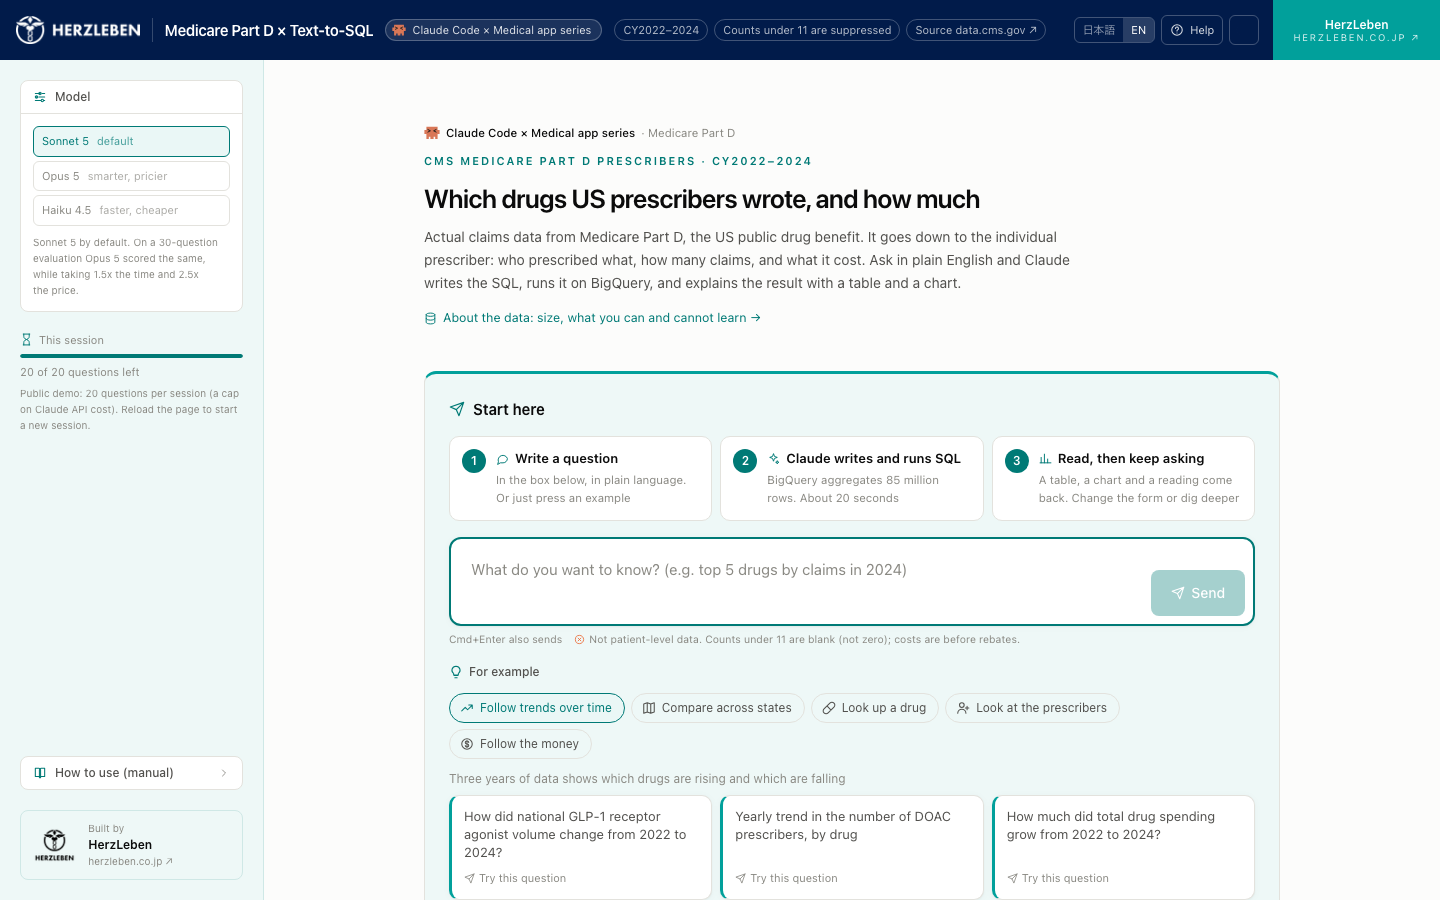
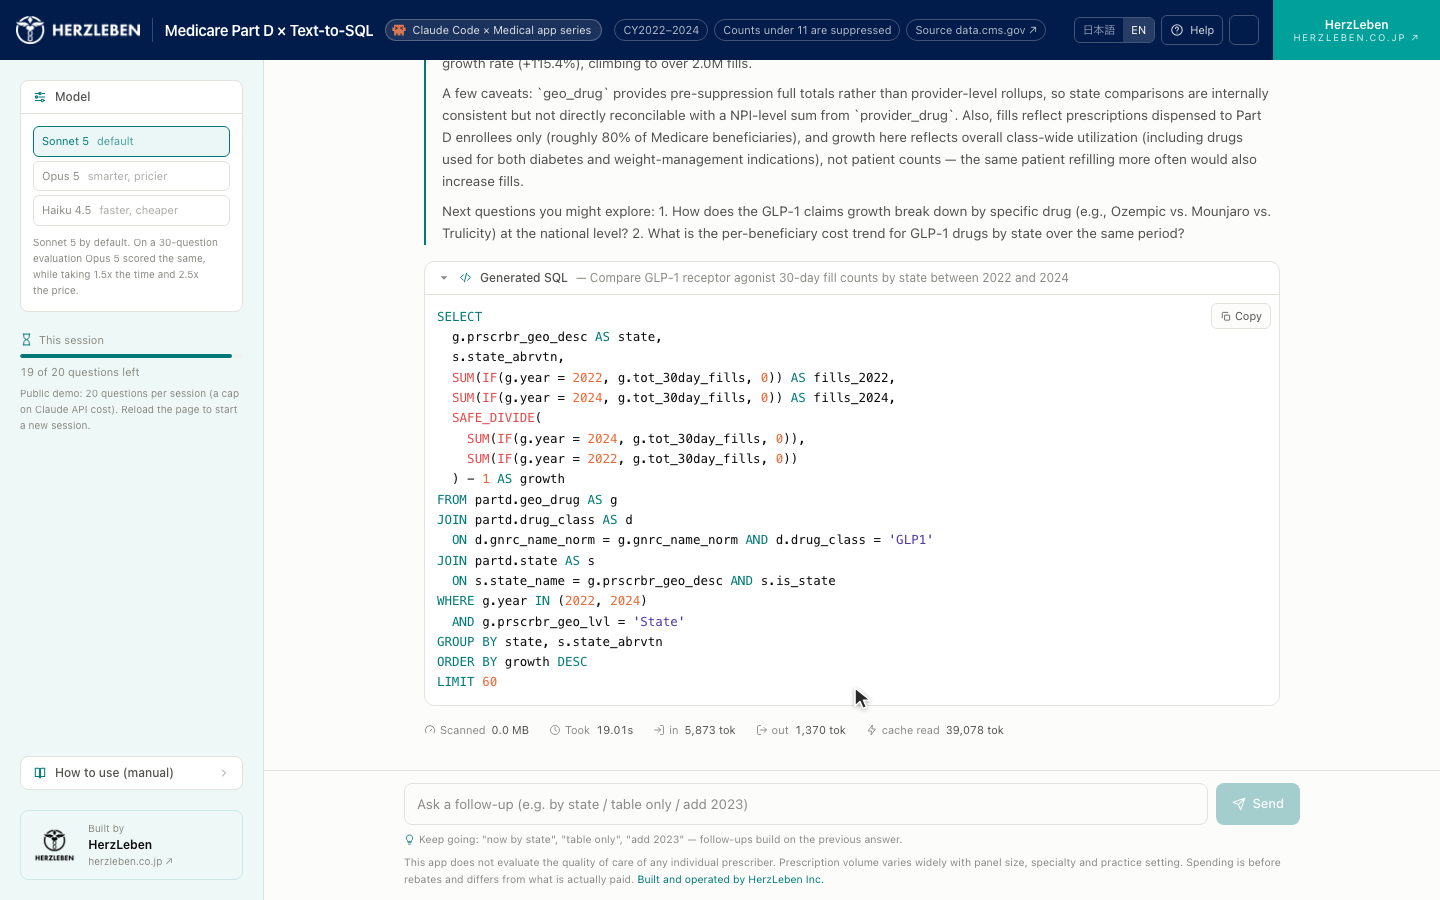
- 日本語(または英語)で質問を入力すると、Claude が BigQuery 用の SQL を生成し、実行し、結果を表とグラフで返す
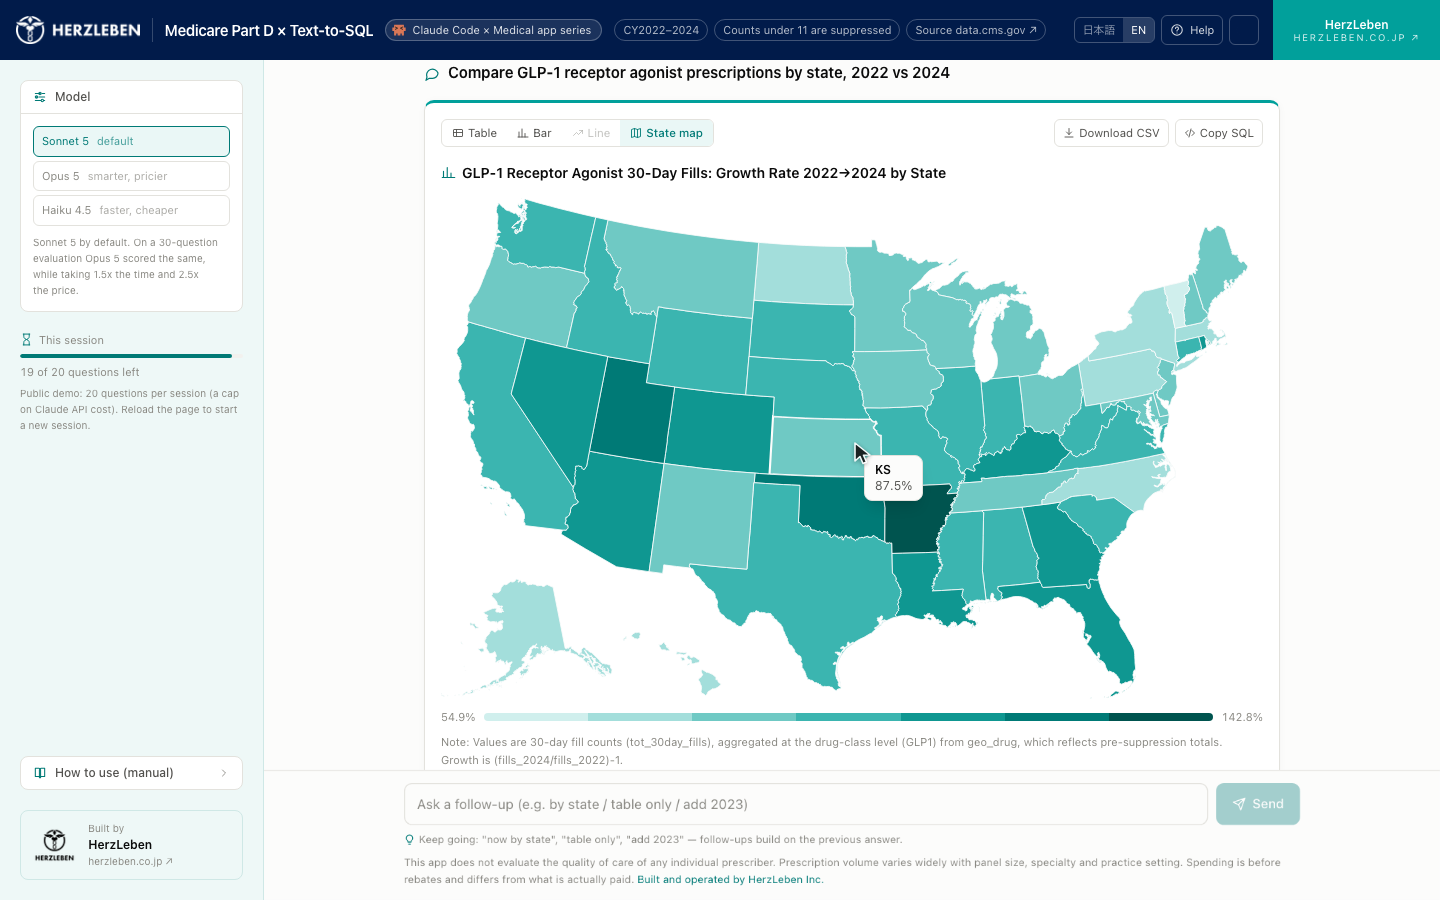
- グラフの種類(棒・折れ線・州別地図・表)は Claude が結果に応じて選ぶ。ボタンひとつで表・棒・地図に切り替えられ、SQL は再実行されない
- 結果に対して Claude が3〜5文の解釈を付け、次に聞くとよい質問を2つ提案する
- 生成された SQL は折りたたみで常に確認でき、コピーできる
- 年・州・専門科・薬効クラスのフィルタで、質問の前に範囲を絞れる
- 11件未満の抑制で欠けている行数を、集計結果と一緒に表示する
3-2. 技術構成
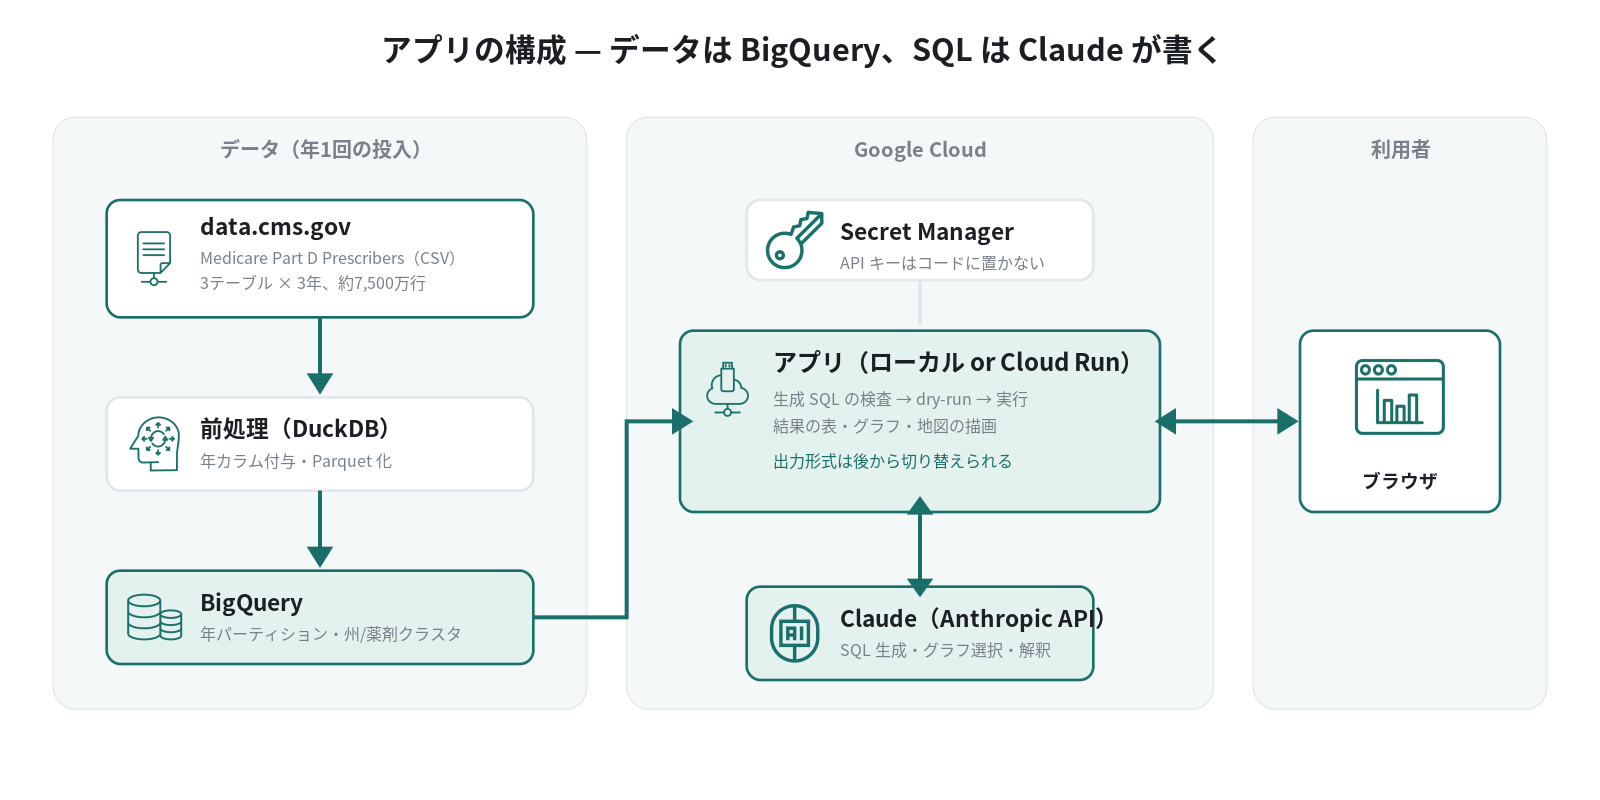
| 役割 | 使うもの | 選んだ理由 |
|---|---|---|
| データ保管・集計 | BigQuery | CSV を投げればすぐ叩ける。2,500万行の集計が数秒で返る |
| アプリの実行 | ローカル、または Cloud Run | 手元で動かすのが基本。公開したい人だけ Cloud Run(Part4) |
| SQL 生成・解釈 | Claude(Anthropic API) | tool use で「SQL 実行」と「可視化仕様」を別ツールに分け、生成 SQL をアプリ側で検査してから実行できる |
| 開発 | Claude Code | 設計書とデータ辞書を渡し、データ投入からデプロイまでを対話で進める |
3-3. Claude Code で作るということ
本シリーズのもう一つの主題は、「Claude Code にどこまで任せられるか」です。
📷 スクショ予定:Claude Code の画面。最初のプロンプトを投げて、ファイル一覧が生成されていくところ。キャプション「渡したのはコードではなく、CLAUDE.md・設計書・データ辞書の3文書」
最初の指示はこれだけです。
CLAUDE.md と docs/ 配下を読んでから始めてください。フェーズ1「データ」から着手します。
まず CY2024 の Geography and Drug(最小ファイル)だけで疎通確認してから、残りのファイル・年に広げてください。
外部に影響するコマンドは実行前に見せてください。詰まった点は docs/DEPLOY.md に日付付きで残してください。
ここから、データ投入 → プロンプト設計 → エージェント実装 → UI → 精度評価 → 公開の6フェーズを Claude Code と進めました。どこで任せ、どこで人が判断したかを、Part2 以降で実際の画面と一緒に書きます。
3-4. 配布の方針 — アプリは GitHub で公開、動かすのはあなたの環境
このアプリは私たちが常時公開するのではなく、コード一式を GitHub で公開し、読者が自分の環境で動かす形にします。Claude の API キーは各自のものを使います。
- 必要なもの:Anthropic の API キー、Google Cloud のプロジェクト、Python
- ローカルで動かすだけなら Cloud Run は不要。Part4 は「自分の GCP に公開したい人向け」の手順として書きます
- ライセンスは MIT。社内データに差し替えて使うときの注意は Part2 で扱います
4. まとめ
- 米国には「処方医 × 薬剤」の粒度で医師名付きの処方データが無料公開されており、日本にはこの粒度の公開データはない
- 生成 AI をデータ分析に組み込む設計(プロンプト、ガード、精度の測り方)は、公開データで先に固めるのが早い
- 本シリーズでは、Claude Code に設計書を渡してアプリを作る過程を全部見せ、コードは GitHub で公開する。動かすのは読者自身の環境(API キーは各自)
次のステップ
次はデータそのものを解説します。Medicare と Part D の仕組み、3つのテーブルの構造、主要な列、抑制ルール、そして「このデータでできないこと」を、CMS の公式データ辞書をもとに整理します。
出典
- CMS, Medicare Part D Prescribers (data.cms.gov)
- CMS, Medicare Part D Prescribers Datasets: A Methodological Overview
- 厚生労働省, NDB オープンデータ
コードは GitHub で公開しています: github.com/HerzLeben/medicare-partd-text-to-sql